Claude Codeを本番開発で使うには?ハーネス設計の8ステップ
Claude Codeを試しには使えても、チームの本番開発ではうまく回らない。その原因と対策を、モデルの外側の仕組み「ハーネス」の考え方で8ステップに整理して解説します。CLAUDE.md、Hooks、Skills、権限、コストまで、今日から始められる手順も紹介します。
要点
- Claude Code が本番で失速する原因の多くは、モデルではなくモデルの外側の仕組み(ハーネス)にある
- 必要な情報だけを必要なときに入れ、確実に守らせたいことはプロンプトではなく仕組みに置く
- Project 層の CLAUDE.md は簡潔に保ち、分野別の規約は paths 付きの Rules に分ける
- lint とテストは Stop Hook で強制し、失敗時は exit code 2 で Claude に応答を終わらせない
- 制約で縛るのは思考ではなく行動で、影響が大きく取り消せない操作には人の承認を挟む
目次
Claude Code にプロンプトを一行渡すだけで、見栄えのよいデモができあがる。ところが、同じやり方をチームの本番開発に持ち込むと、次のような壁に当たりがちです。
- 新しいセッションを始めるたびに、プロジェクトの技術スタックや規約を忘れてしまう
- 会話が長くなると、だんだん的外れな回答が増え、同じところを堂々巡りする
- 生成されたコードに隠れたバグや不要な依存が入り、PR が何度も差し戻される
こうした問題は、モデルの性能不足よりも、モデルの外側の仕組みが整っていないことが原因である場合が少なくありません。この記事では、その仕組みを「ハーネス(Harness)」と呼び、本番開発で Claude Code を使いこなすための設計を8つのステップに分けて解説します。
この記事でわかること
- Claude Code が本番開発で失速する理由と、「Agent = Model + Harness」という考え方
- CLAUDE.md や Rules を使ったメモリの分け方と、コンテキストに入れる情報の選び方
- Stop Hook でテストや lint を強制する設定例
- AI に任せる範囲の決め方と、Skill / SubAgent / Workflow / Agent Team の使い分け
- 長期タスクの管理、コストの下げ方、本番運用での責任の持ち方
- 今日から始められる3つのこと
Claude Codeが本番で失速する理由:Agent = Model + Harness
ハーネスとは何か
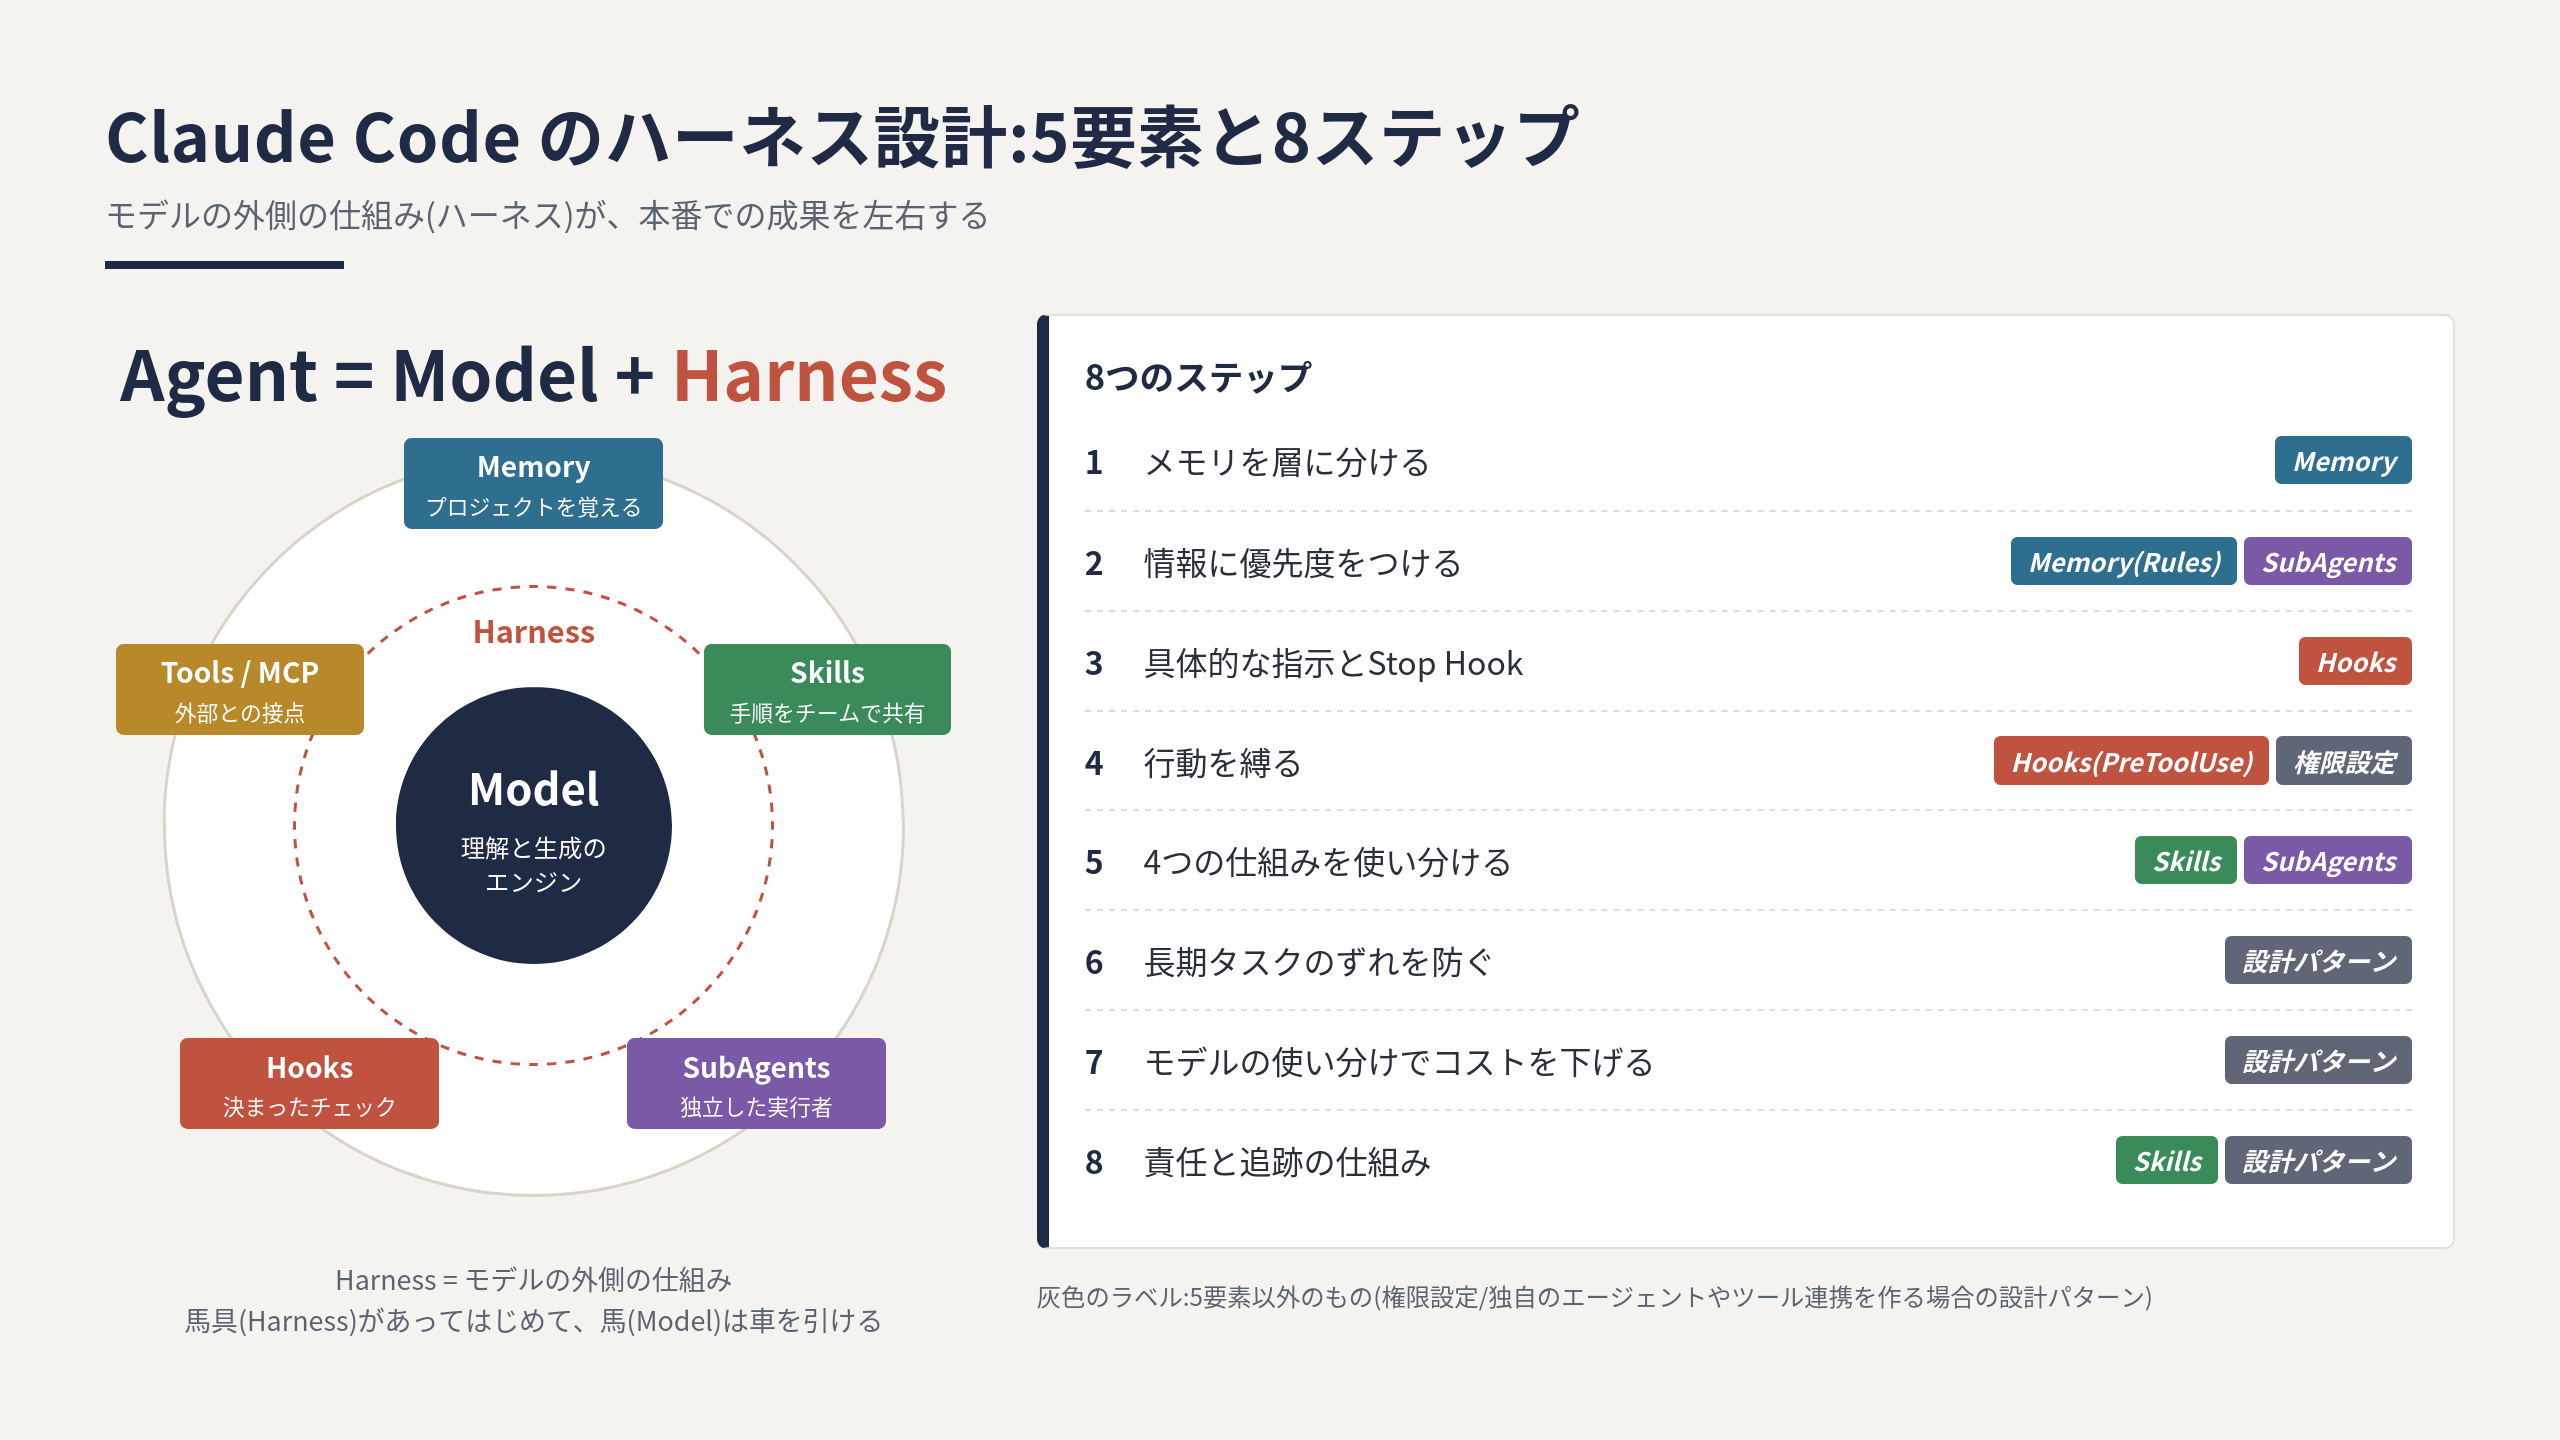
本番で使える AI エージェントは、次の式で表せます。
Agent = Model + Harness
Harness はもともと「馬具」を指す言葉です。馬は力が強くても、馬具がなければ車を引くことはできません。大規模言語モデルも同じで、モデル自体は理解と生成の能力を持つ「エンジン」にすぎません。そのエンジンを実際の仕事につなげるための、モデルの外側の仕組み全体がハーネスです。
具体的には、次のようなものがハーネスに含まれます。
- どの情報をモデルに読ませるか(コンテキストの管理。コンテキストとは、モデルが一度に読み込める情報の範囲のことです)
- どのツールをどう呼び出させるか
- 決まったタイミングで必ず行うチェック
- 作業の途中経過の保存
この考え方が注目されているのは、「同じモデルでも、ハーネスが違えば性能が大きく変わる」という報告が出てきているためです。たとえば次のような例が紹介されています。
- Terminal-Bench 2.0 で、ハーネス層を改善しただけで、同じモデルのエージェントが30位圏外から上位5位以内に入った
- エージェントに持たせるツールを8割削ったところ、手順が簡潔になってトークン消費が減り、応答も速くなった
本番で成果を出すには、どのモデルを使うかだけでなく、ハーネスをどう設計するかが重要になります。
ハーネスを構成する5つの要素
Claude Code のハーネスは、次の5つの要素で考えると整理しやすくなります。
| 要素 | 役割 |
|---|---|
| Memory(記憶) | CLAUDE.md / Rules / 自動メモリ。セッションをまたいでプロジェクトのことを覚えさせる |
| Skills(技能) | 内容に応じて呼び出される、チームで再利用できる手順書 |
| SubAgents(サブエージェント) | 独立したコンテキストを持つ実行者。作業を分けてメインの会話を汚さない |
| Hooks(フック) | 決まったタイミングで必ず実行されるチェック。モデルの記憶に頼らず品質を守る |
| Tools / MCP(ツール) | 外部のシステムとつながる接点。実際の行動を担う。MCP は外部ツールと接続するための標準的な仕組み |
この後の8つのステップは、主にこの5要素と、それを応用した設計パターンで実現します。
ステップ1:CLAUDE.mdとRulesでメモリを層に分ける
すべての規約を一つのファイルに詰め込むのは逆効果です。読み込まれる情報が増えるほど、一つひとつのルールが守られにくくなります。メモリは次の5つの層に分けて管理します。
| 層 | 置く場所の例 | 書く内容 |
|---|---|---|
| Enterprise(組織) | 組織で配布する CLAUDE.md | 「コードを外部 API に送らない」「秘密鍵をハードコードしない」など、例外を認めないセキュリティ・コンプライアンス方針 |
| User(個人) | ~/.claude/CLAUDE.md | やり取りの言語など、自分だけの好み |
| Project(プロジェクト) | リポジトリの CLAUDE.md | 「フレームワークは Fastify、パッケージ管理は pnpm」など、チームで共有する規約 |
| Rules(分野別ルール) | .claude/rules/*.md | フロントエンド、DB マイグレーション、テスト方針など分野ごとの規約 |
| Local(個人のメモ) | CLAUDE.local.md | プロジェクト内の個人的な一時メモ。自分で .gitignore に追加してコミットしない |
ポイントは2つです。
- Project 層の CLAUDE.md は資料置き場ではありません。毎回必ず読み込まれる最重要の枠なので、一行一行が意味のあるルールになるよう簡潔に保ちます。
- 分野別のルールは Rules に分けます。ファイル冒頭の YAML frontmatter で
pathsに対象ファイルの Glob パターンを書くと、該当するファイルを扱うときだけ読み込まれます。たとえばtests/**を操作するときだけテスト方針を読み込む、といった使い方ができます。
ステップ2:情報に優先度をつけてコンテキストに入れる
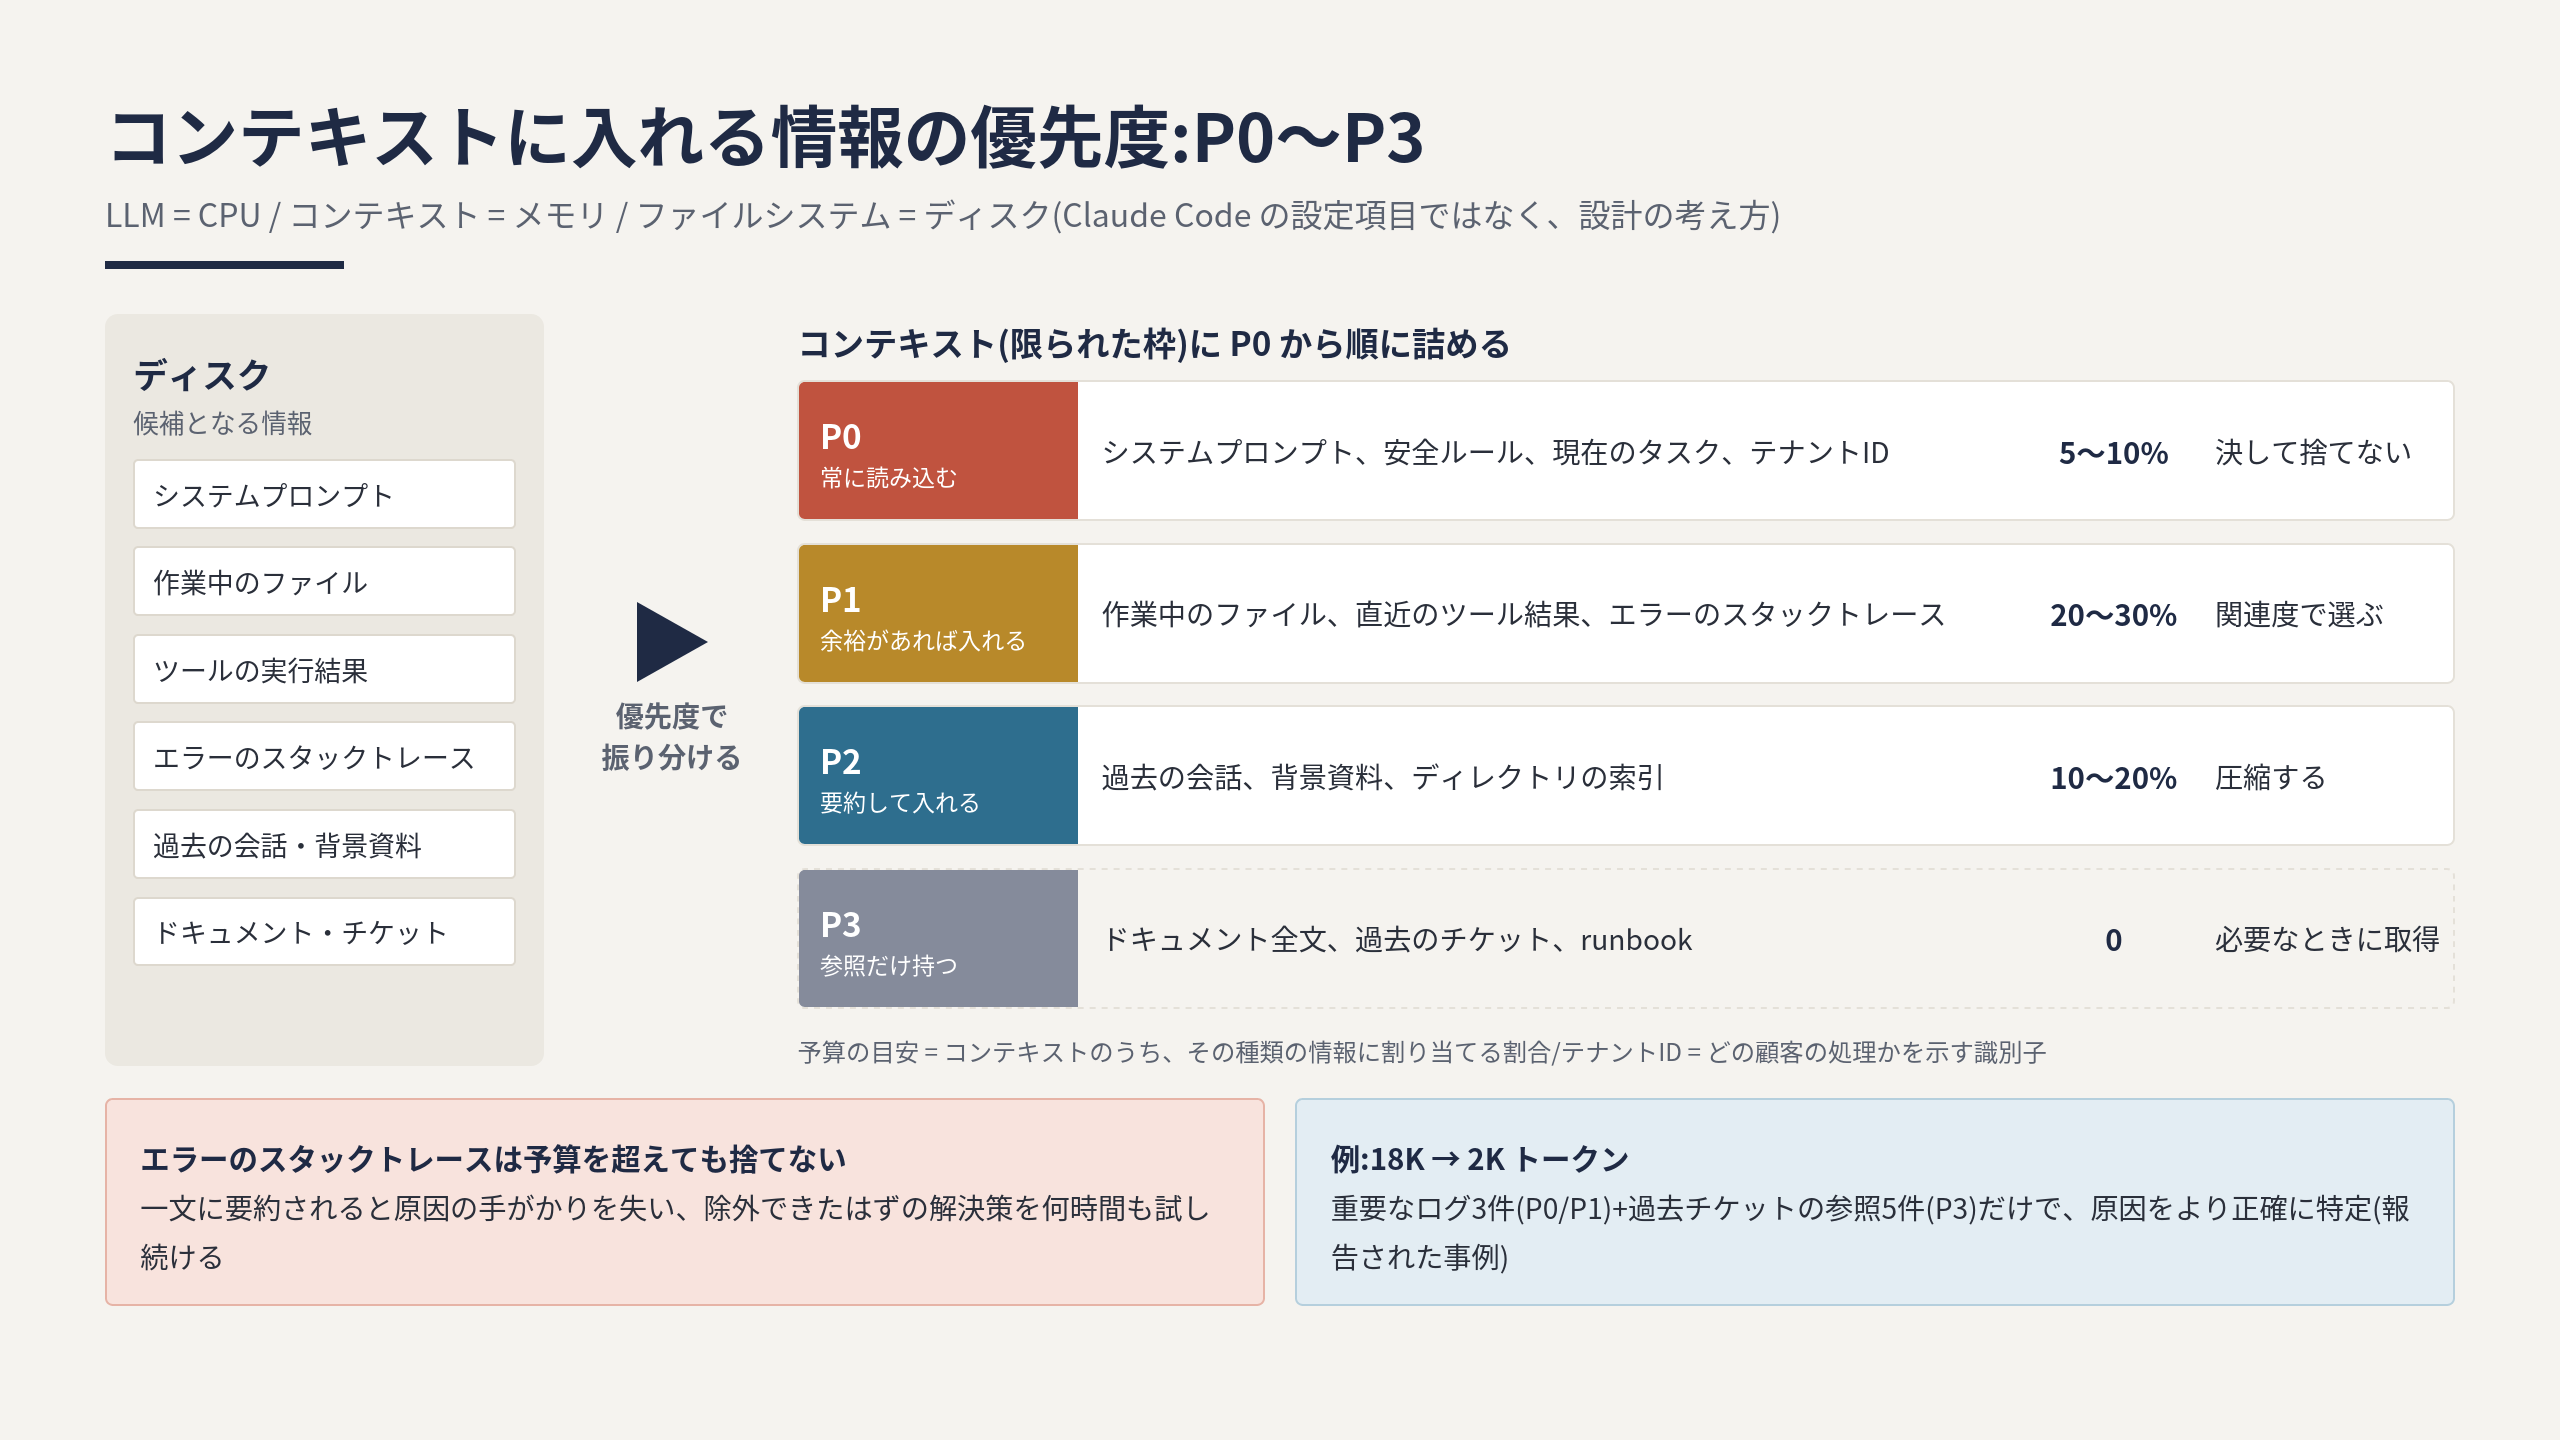
大きなコードベースでは、すべてをコンテキストに入れることはできません。
ここで紹介するのは Claude Code の設定項目ではなく、エージェントに渡す情報を設計するときの考え方です。Claude Code では、ステップ1の Rules や、ステップ5で紹介する SubAgent がこの考え方を実現する手段になります。
その土台になるのが、LLM を CPU、コンテキストをメモリ、ファイルシステムをディスクにたとえる見方です。パソコンがディスクの中身をすべてメモリに載せないのと同じように、候補となる情報を4段階に振り分けて読み込みます。
| レベル | 何を入れるか | 予算の目安 | 扱い |
|---|---|---|---|
| P0 常に読み込む | システムプロンプト、安全ルール、現在のタスク、テナントID | 5〜10% | 決して捨てない |
| P1 余裕があれば入れる | 作業中のファイル、直近のツール実行結果、エラーのスタックトレース | 20〜30% | 関連度で選ぶ |
| P2 要約して入れる | 過去の会話、背景資料、ディレクトリの索引 | 10〜20% | 圧縮する |
| P3 参照だけ持つ | ドキュメント全文、過去のチケット、運用手順書(runbook) | 0% | 必要なときに取得する |
※ 予算は、コンテキストのうちその種類の情報に割り当てる割合です。テナントIDは、どの顧客の処理かを示す識別子です。
P0 から順に、予算を使い切るまで詰めていきます。P3 は最初から読み込まず、必要になったときにツールで取りに行きます。
特に大切なのは、エラーのスタックトレースを予算オーバーでも残すことです。
長いセッションでは、コンテキストが上限に近づくと、Claude Code が会話を自動で要約・圧縮(compact)します。このとき、たとえば「コネクションプールが枯渇した」ことを示す詳しいスタックトレースが、「a database error occurred」の一文に縮められてしまうことがあります。すると AI は原因の手がかりを失い、スタックトレースを見ればすぐに除外できた解決策を何時間も試し続けることになります。
逆に、うまく振り分けた例もあります。「注文の引き落としが失敗する」問題を調べたケースでは、重要なログ3件(P0/P1)と過去チケットへの参照5件(P3)だけを入れて、コンテキストを 18K トークンから 2K トークンまで減らしました。読ませる量を減らしたことで余計な情報も消え、かえって原因を正確に特定できたと報告されています。
ステップ3:具体的な指示とStop Hookで幻覚を減らす
AI は、一見正しそうで実は間違っているコードを書くことがあります。いわゆる「幻覚(ハルシネーション)」です。これを減らす方法は2つあります。
1つ目は、指示を具体的にすることです。ゼロから考えさせるのではなく、既存のコードのどこを直すのかを示して修正させます。
- 悪い例:この関数を最適化して
- 良い例:
src/utils/parser.tsのparseConfig関数を最適化して。ボトルネックは42行目のループ
2つ目は、品質を仕組みで守ることです。
プロンプトはお願い、Hook は契約。
プロンプトで「テストを通してから終わって」と何度頼んでも、守られる保証はありません。そこで使うのが Stop Hook です。
Hook(フック)は、決まったタイミングで指定したコマンドを自動実行する仕組みです。Stop Hook は、Claude が応答を終えようとしたときに実行されます。ここで lint(コードの書き方のチェック)とテストを走らせ、失敗したら Claude に応答を終わらせず、エラー内容を返します。Claude はその内容をもとに修正を続け、テストが通ってはじめて作業を終えます。
設定は .claude/settings.json に書きます。
{
  "hooks": {
    "Stop": [
      {
        "hooks": [
          {
            "type": "command",
            "command": "\"$CLAUDE_PROJECT_DIR\"/.claude/hooks/check.sh"
          }
        ]
      }
    ]
  }
}
呼び出すスクリプト .claude/hooks/check.sh の例です。
#!/bin/bash
if ! (pnpm lint && pnpm test) >&2; then
  echo "lint またはテストが失敗しています。修正してから完了してください。" >&2
  exit 2
fi
exit 0
設定のポイントは次のとおりです。
- スクリプトには実行権限を付けておきます(
chmod +x .claude/hooks/check.sh)。 - スクリプトを exit code 2 で終わらせると、Claude は応答を終えられません。このとき標準エラー出力の内容が、作業を続ける理由として Claude に渡されます。
- Stop イベントは
matcherに対応していないため、書く必要はありません(書いても無視されます)。 - Stop Hook が止めるのは「Claude の応答の終了」です。git のコミットを止めるものではありません。
※ Hooks の仕様は、2026年10月時点の公式ドキュメントに基づきます。
ステップ4:縛るのは「思考」ではなく「行動」
「バグは直してくれたが、ついでに触ってはいけないセキュリティ関連の処理を3か所書き換えていた」。AI に仕事を任せると、こうしたことが起こります。
これを防ごうとして、プロンプトで考え方の手順まで細かく指定するのは、よくある失敗です。かえってモデルが自由に推論する余地を狭めてしまいます。
制約で決めるのは行動の範囲であって、考え方ではない。
制約を置くべきなのは、実際に何かが変更され、副作用が生じる場面です。失敗したときに影響が及ぶ範囲(「爆発半径」と呼ばれます)に応じて、次の3段階で扱うのが基本です。
| 操作の種類 | 扱い |
|---|---|
| 影響が小さい操作(コードの検索、ドキュメントの閲覧など) | 自動で許可し、作業を止めない |
| 影響が中程度の操作(書き込みを伴うもの) | 許可したうえで記録を残す。操作ごとに識別できるログを取り、あとから経緯を再現して追えるようにする |
| 影響が大きい操作、取り消せない操作 | 必ず止めて、人の承認を求める。人が確認してはじめて先へ進む |
最後の「人が承認してから進める」方式は、HITL(Human-in-the-Loop)と呼ばれます。
Claude Code では、権限設定(permissions の allow / ask / deny)や、ツール実行前に動く PreToolUse Hook を使うと、この3段階に近い制御ができます。
ステップ5:Skill・SubAgent・Workflow・Agent Teamを使い分ける
任せる仕事が増えてくると、「どの仕組みで組み立てればよいか」で迷います。エージェントの設計でよく出てくる4つを整理しておきましょう。
まず Skill です。チームの誰かが書いた良いプロンプトは、そのままでは本人の頭の中にしか残りません。Claude Code では、よく使う手順を .claude/skills/ 配下に Skill としてまとめ、Git でバージョン管理できます。新しいメンバーは、リポジトリを clone するだけでチームのノウハウを受け継げます。
Skill の実体は、SKILL.md を含むディレクトリです。トークンを節約するため、Skill は段階的に読み込まれます。
- 起動時:各 Skill の
nameとdescriptionだけを読み込む(約100トークンのメタデータ) - 一致時:ユーザーの入力が Skill の内容に合ったとき(たとえば「コードをレビューして」)、
SKILL.mdの本文を展開する - 実行時:実際に必要になった段階で、同梱のスクリプトや外部リソースを呼び出す
本の目次だけを手元に置いておき、必要な章を開いたときにだけ中身を読むイメージです。Skill をいくつも使う構成では、この仕組みによってトークンを約98%節約できるとされています。
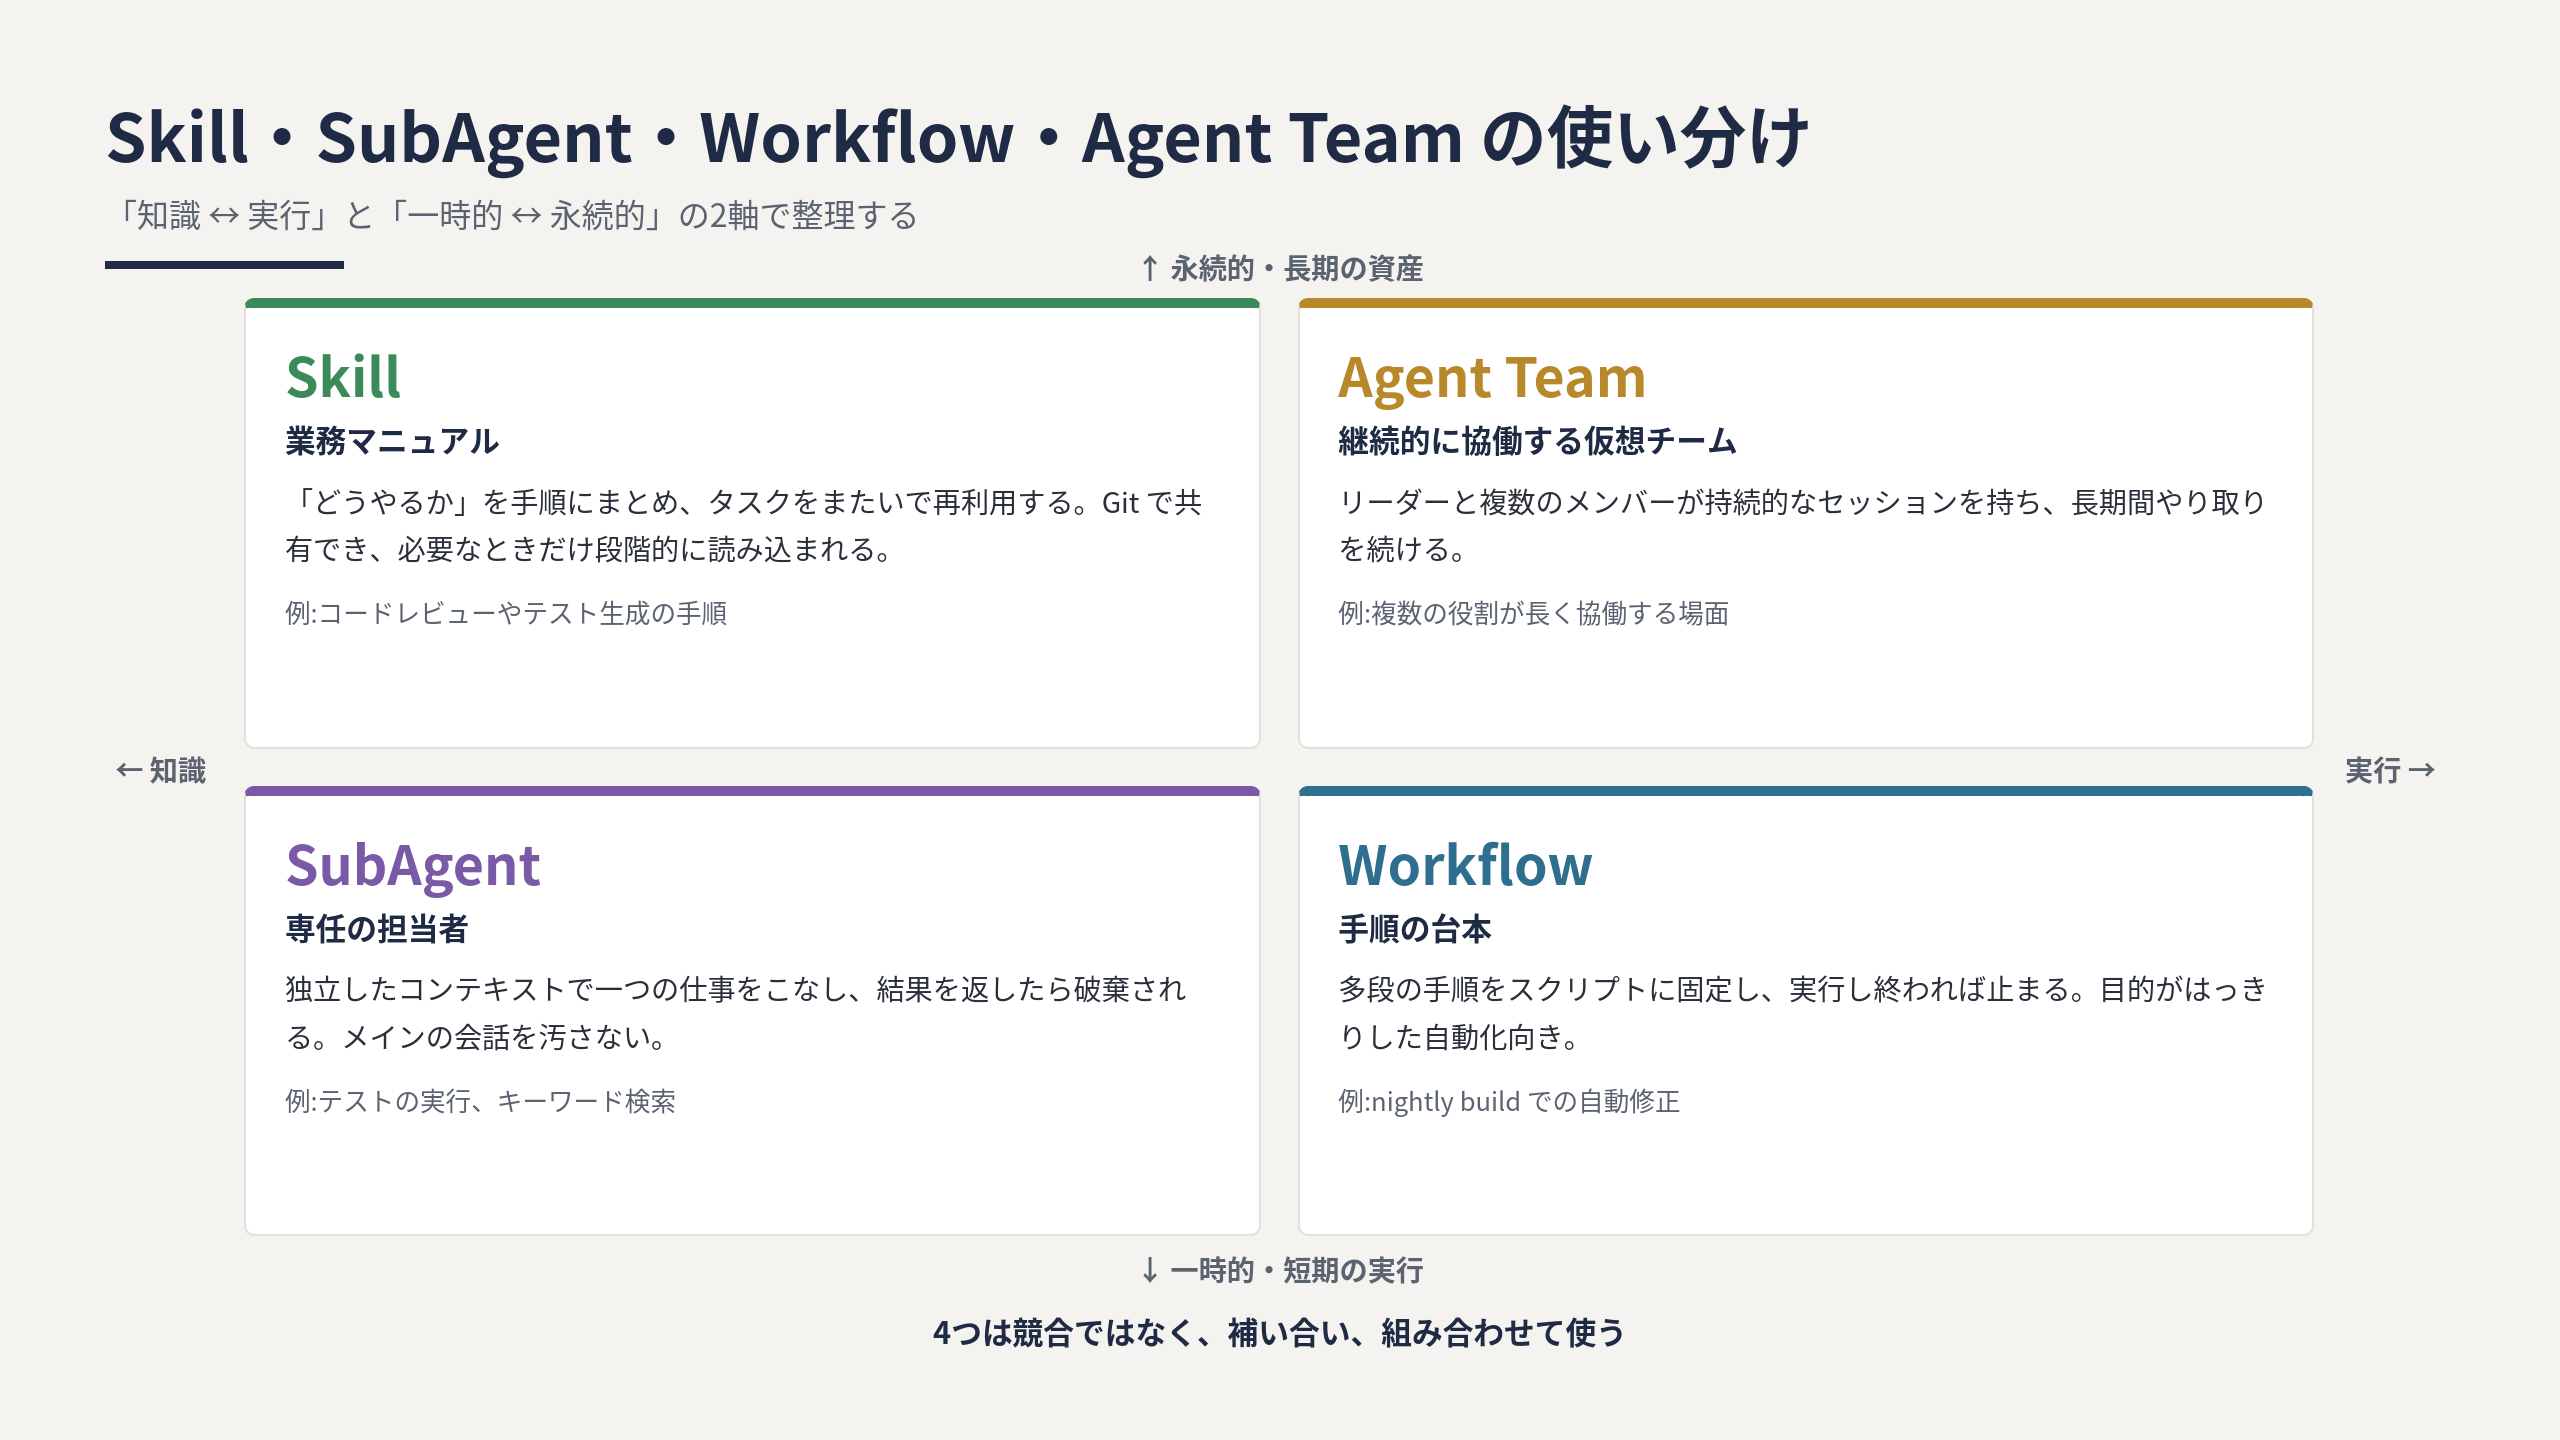
Skill と他の3つとの違いは、「知識 ↔ 実行」と「一時的 ↔ 永続的」の2軸で並べるとはっきりします。
| 知識寄り | 実行寄り | |
|---|---|---|
| 永続的・長期の資産 | Skill:業務マニュアル。「どうやるか」をまとめ、タスクをまたいで再利用する | Agent Team:継続的に協働する仮想チーム。リーダーと複数のメンバーが持続的なセッションを持つ |
| 一時的・短期の実行 | SubAgent:専任の担当者。独立したコンテキストで一つの仕事をこなし、結果を返したら破棄される | Workflow:手順の台本。多段の手順をスクリプトに固定し、実行し終われば止まる |
- SubAgent は、テストの実行やキーワード検索などを別のコンテキストで行い、メインの会話に余計な情報を持ち込みません。
- Workflow は、nightly build での自動修正のように、目的がはっきりした多段の自動化に向いています。
- Agent Team は、複数の役割が長期間にわたってやり取りする場面に使います。
この4つは競合するものではありません。成熟したプロジェクトでは、入れ子にして組み合わせることがよくあります。
ステップ6:長期タスクのずれを防ぐ状態管理
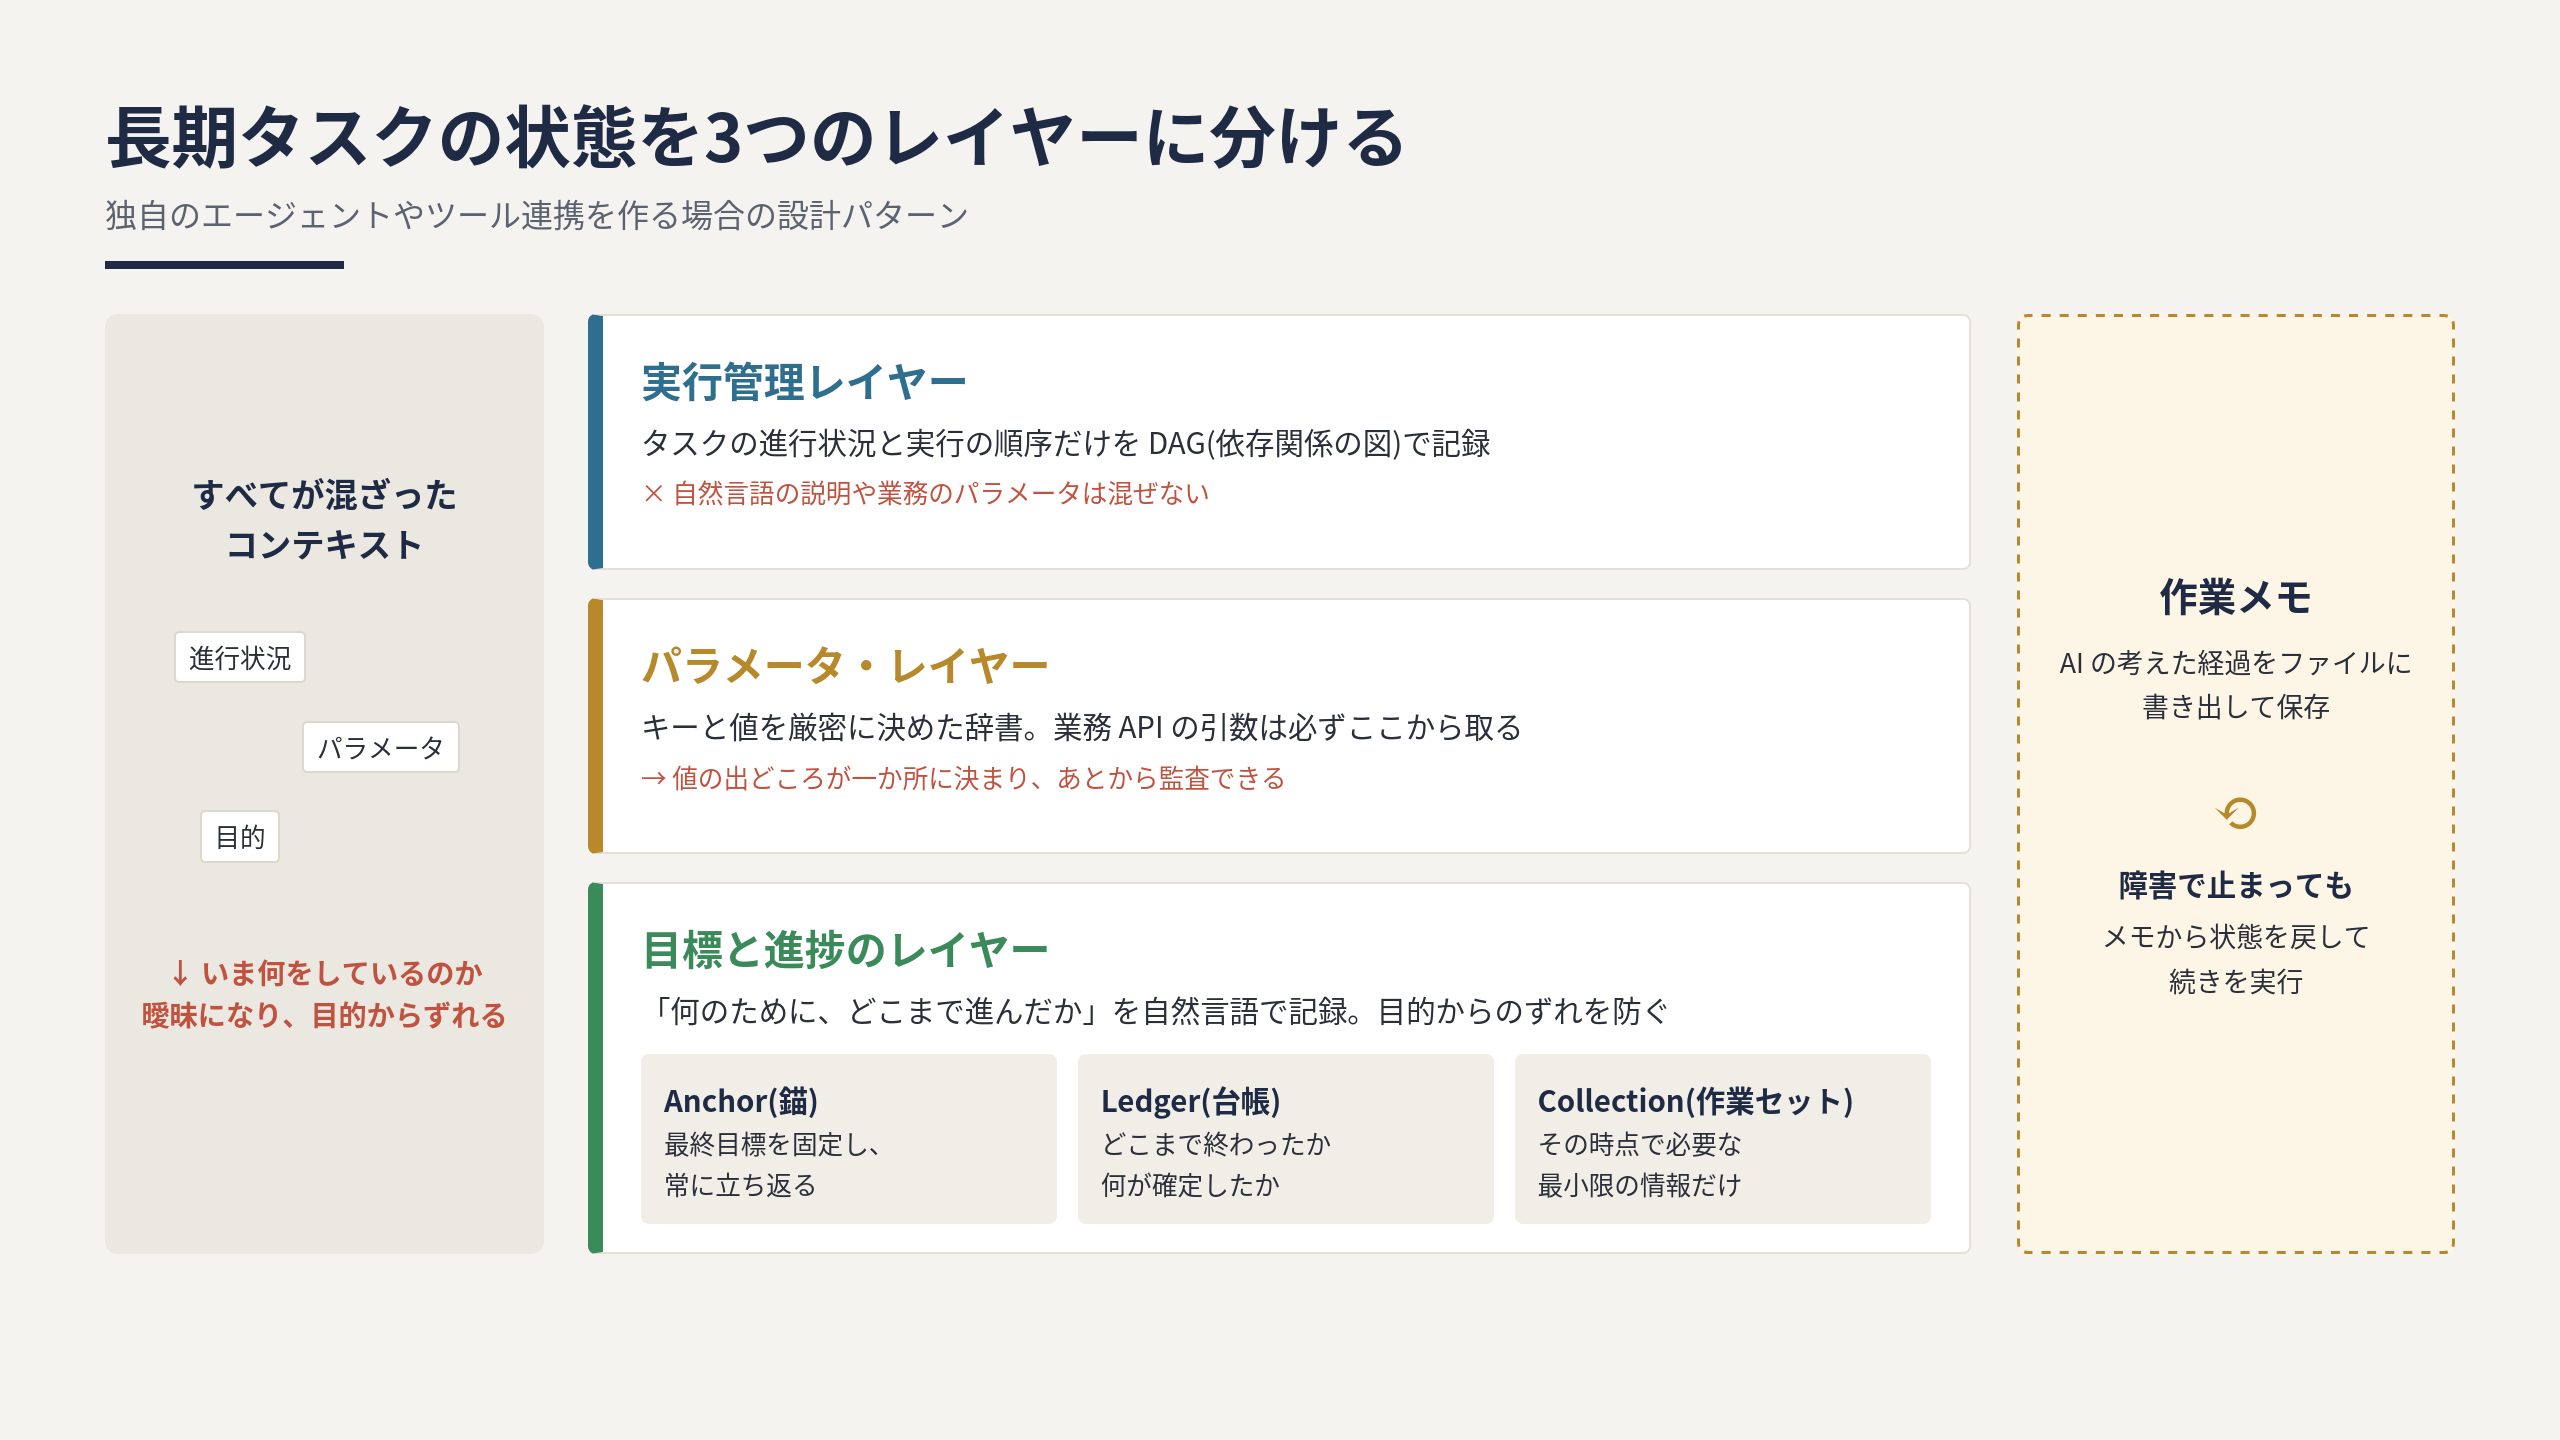
複雑で長いタスクを任せると、途中で本来の目的からずれていくことがあります。複数のシステムを操作しながら長く作業を続けると、進行状況・パラメータ・目的がひとつのコンテキストに混ざり、「いま何をしているのか」が曖昧になるためです。
このステップは、独自のエージェントやツール連携を作る場合の設計パターンです。
金融向け SaaS でエージェントを運用した事例では、状態を3つのレイヤーに分けて管理しました。
- 実行管理レイヤー:タスクの進行状況と実行の順序だけを記録します。形式は DAG(作業の依存関係を矢印でつないだ図)です。自然言語の説明や業務のパラメータは混ぜません。
- パラメータ・レイヤー:キーと値を厳密に決めた辞書です。業務 API に渡す引数は、必ずここから取ります。値の出どころが一か所に決まるため、あとから監査できます。
- 目標と進捗のレイヤー:「何のために、どこまで進んだか」を自然言語で記録します。目的からのずれを防ぐ役割を持ち、次の3つで構成されます。
- Anchor(錨):ユーザーの最終的な目標を固定して書いておきます。やり取りが何十回続いても、常にここに立ち返って方向を確認します。
- Ledger(台帳):「どこまで終わったか」「何が確定したか」をマイルストーンごとに記録します。
- Collection(作業セット):状態全体は大きすぎるため、各段階で AI に見せるのは、その時点で必要な最小限の情報だけにします。
さらに、AI の思考過程を「作業メモ」としてファイルに書き出しておきます。人が読んで確認でき、障害で処理が止まっても、このメモから状態を戻して続きを実行できます。
ステップ7:モデルの使い分けでコストを下げる
ステップ6と同じく、独自のエージェントを作る場合の話です。
すべてを最上位の Opus で処理すると、費用が大きく膨らみます。まずは、タスクの性質でモデルを使い分ける表を作りましょう。
| モデル | 向いているタスク | コストの目安 | 使う場面 |
|---|---|---|---|
| Haiku | 簡単・高頻度・走査系 | 最も低い(基準 1×) | 大量ファイルの grep、分類、圧縮、走査 |
| Sonnet | 日常の開発 | 中程度(Haiku の約20倍) | コードを書く、バグを直す、レビュー |
| Opus | 複雑な設計判断 | 高い(Haiku の約40倍) | アーキテクチャの選定、難しい推論、取り消せない判断の前の再確認 |
※ 2026年10月時点の API 料金(Haiku 5.5 は10万トークン以下のプロンプトの場合)で比較しています。倍率はモデルの世代によって変わります。
実際の業務でリクエストの複雑さを集計したところ、41%は SQL のテンプレートに値を埋めるだけの単純なもので、最も安い Haiku で十分だったという例があります。Haiku(60%)→ Sonnet(30%)→ Opus(10%)の3段階で振り分けた結果、品質を保ったまま全体のコストが65〜75%削減されたと報告されています。
予算や環境の制約で、安いモデル(Haiku や、ローカルで動かす Qwen-32B などのオープンソースモデル)しか使えない場合もあります。そのときは、モデルを強くするのではなく、使い方のパターンで補います。たとえば、安いモデルにコードを書かせ、同じく安いモデルにレビューさせ、これを2回繰り返します。合計のコストは最上位モデル1回分よりずっと低く、それでいてタスクによっては最終的な品質が上回ることもあります。
リアルタイムの対話や音声のように、応答の速さが重要な場面もあります。推論モデルは答えるまでに長く考えることがあり(たとえば24秒ほど)、そのあいだ利用者は「止まった」と感じてしまいます。
そこで使えるのが Talker-Reasoner という構成です。カーネマンの「速い思考と遅い思考(二重過程理論)」を参考にしたもので、役割を2つに分けます。
- Talker(話す役):約200ms で応答できる速くて安いモデル(Haiku など)。すぐに返事をして会話をつなぎます。
- Reasoner(考える役):推論が強いぶん遅いモデル(Opus など)。裏でじっくり推論し、その時点での判断を Talker に渡し続けます。
こうすることで、考えている時間を利用者に感じさせずに済みます。
ステップ8:責任と追跡の仕組みを作る
コードが書けることと、システムとして納品できることは別の話です。本番で障害が起きたとき、AI が責任を負うことはできません。責任を持つのは常に人です。だからこそ、問題が起きたときに原因をさかのぼれる仕組みを用意しておきます。
ここでも、独自のエージェントを作る場合を想定します。その中心になるのが Provenance(出どころの追跡) です。システム内のパラメータ一つひとつについて、次の情報を記録しておきます。
- どのツールが生み出した値か
- ツールの応答のどの部分から取り出したか
- 何回目のやり取りで生まれたか
- どのユーザー入力がきっかけだったか
あわせて、チームで次の2つのルールを守ります。
- ルールは先に書いておく:役割ごとのルールは、問題が起きてからプロンプトで付け足すのではなく、最初から Skill や
.claude/agents/のサブエージェント定義などのファイルに書いておきます。 - 作業前に評価させる(Pre-task gating):AI がコードを書き始める前に、「これをやり遂げるには、どんな情報が足りないか、何を確認すべきか」を先に答えさせます。評価なしには実装させません。
まず始める3つのこと
8つのステップを一度に整える必要はありません。取りかかりやすいのは次の3つです。
- Project 層の CLAUDE.md を見直す:チームで必ず守るルールだけを残し、分野別の規約は
.claude/rules/に移します(ステップ1)。 - Stop Hook で lint とテストを強制する:ステップ3の設定例の
pnpm lintとpnpm testを、自分のプロジェクトのコマンドに置き換えれば使えます。 - よく使うプロンプトを一つ Skill にする:コードレビューやテスト生成など、チームで繰り返している作業から始めます(ステップ5)。
よくある質問
ハーネスエンジニアリングとプロンプトエンジニアリングは何が違いますか?
違いは、設計の対象の広さです。プロンプトエンジニアリングは「一回の指示をどう書くか」、コンテキストエンジニアリングは「モデルに何を読ませるか」を扱います。ハーネスエンジニアリングはそれらを含み、ツールの呼び出し、決まったタイミングでのチェック、作業状態の保存まで、モデルの外側の仕組み全体を対象にします。
CLAUDE.mdは何行くらいに収めればよいですか?
公式ドキュメントでは、CLAUDE.md は1ファイルあたり200行未満を目安にすることが推奨されています。長くなるほどコンテキストを消費し、ルールが守られにくくなるためです。一部の場面でしか使わないルールは、paths 付きの Rules に移しましょう。
Stop Hookでテストが通らないとき、無限ループになりませんか?
Claude Code には、Stop Hook による継続が連続8回に達すると応答を終える上限があります。ただし、この回数は Claude がツールを使うたびにリセットされるため、「修正してはテストに失敗する」状態が続くと止まらない可能性があります。入力の stop_hook_active を確認したり、スクリプト側で再試行の回数を数えたりして、一定回数で止める仕組みを入れておくと安心です。
※ 2026年10月時点の公式ドキュメントに基づきます。
まとめ
- Claude Code が本番で失速する原因の多くは、モデルではなく ハーネス(モデルの外側の仕組み) にあります。
- 「必要な情報だけを、必要なときに入れる」「確実に守らせたいことは、プロンプトではなく仕組みに置く」の2つが、8つのステップに共通する考え方です。
- 8つのステップを一度に整える必要はありません。「まず始める3つのこと」から、小さく始めるのがおすすめです。
自社システムへの AI 導入、まずは無料でご相談ください
現状を伺ったうえで、進め方をご提案します。初回30分は無料です。
関連記事
Claude Code Superpowers入門|AIに手順を飛ばさせない14のスキル
Claude Codeが「動くけれど頼んでいないことまでやる」原因は、賢さではなく手順を飛ばすことにあります。Superpowersが14個のスキルで設計・計画・実装・デバッグをどう縛るのか、v6.3.0時点の実挙動に沿って、スキルの選び方と使い分けまで解説します。
Claude Code コマンド整理術|「重い」の正体はコンテキスト
Claude Code の応答が重くなる原因は、モデルの性能ではなくコンテキストの使い切りにあります。有限のコンテキストウィンドウを起点に、/context・/compact・/clear など主要コマンドを「減らす・見る・戻す」の3つの役割で整理し、症状別の使い分けを解説します。
Claude Code プランモード入門|「動くけど違う」を減らす3ステップ
Claude Code が「動くけど求めたものと違う」コードを返すのは、範囲と完了条件が渡っていないからです。プランモードで探索・計画・実装を分ける手順と、AI自身が合否を判定できる検証の書き方、テストがない場合の代替まで解説します。