Claude Code でレガシーコード改修|AIに任せる前に決める6つの準備
Claude Code でレガシーコードを改修するとき、詰まるのはコードを書く速さではなく、検証とレビューです。改修の種類の決め方、受け入れ条件、リスクに応じたレビュー、権限設計、小さく試す進め方、コスト見積もりまで、AIに任せる前にそろえておく準備をまとめました。
要点
- AI 改修で詰まるのは書く速さではなく、検証とレビューだ
- 着手前に、どの業務ルールの変更を許すかと、どの検証結果ならマージするかをチームで決める
- 受け入れ条件は改修の種類に合わせ、自動判定できる形で関係者と事前に決める
- レビューの深さはリスクで分け、決済や会計など重要フローは人が全件レビューする
- 同じ間違いが繰り返されたら、個別の修正ではなくエージェントの手順や検査ルールを直す
目次
この記事でわかること
- AIでレガシーコードを改修するとき、本当のボトルネックがどこにあるか
- 改修の種類(バージョンアップ/技術スタック変更/再設計)で、何が「正解」になるか
- Claude Code の Code Modernization プラグインで、現状をどう把握するか
- AIの修正が正しいことを示す「受け入れ条件」の決め方
- 大量の修正を、レビューのボトルネックにしない仕組み
- 権限・環境・コストを含め、着手前にそろえておくもの
対象は、Claude Code を使ったことがあり、社内の古いシステムをAIで刷新できないか検討している開発者やテックリードです。チームでの進め方が中心なので、開発マネージャーにも役立つ内容にしています。
AIでレガシーコードを改修するとき、詰まるのはどこか
長く動いているシステムには、誰も触りたがらないコードがあります。一見ただの条件分岐でも、何年も前に決めた業務ルールが埋まっていることがあります。どこに影響するのか、古くからいるメンバーでも正確には答えられない。そんなコードです。
AIがコードを書けるようになり、「今なら手を付けられるのでは」と考える人は多いはずです。実際、Claude Code に頼めば、大量の修正を短時間で出してくれます。
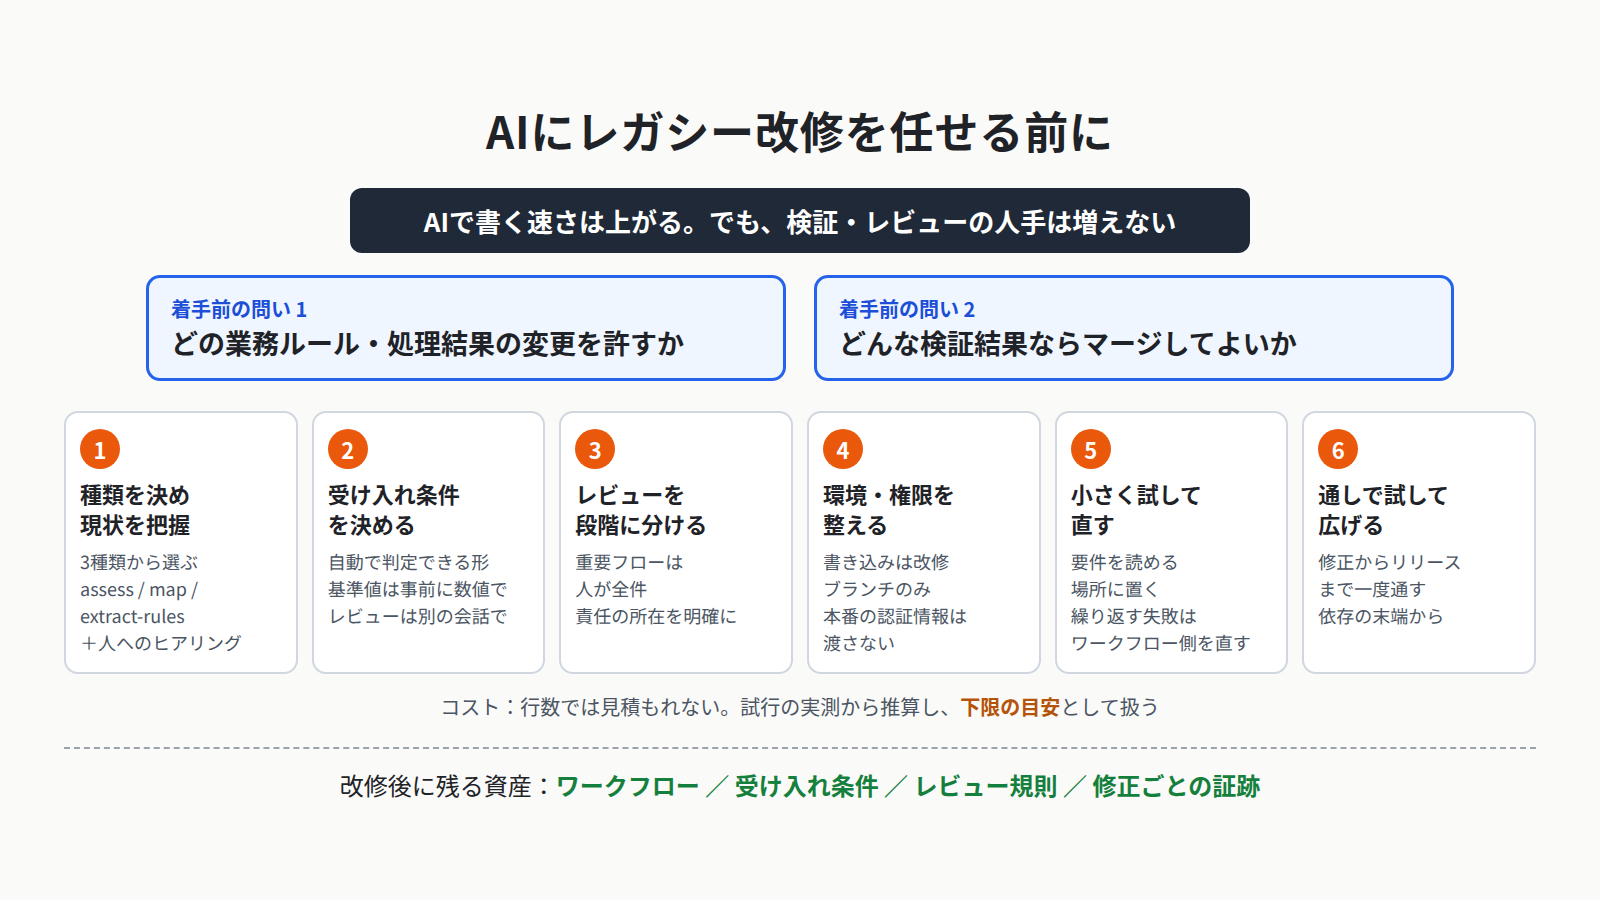
ただ、ここで問題が変わります。書く速さが上がっても、それを確かめる人とレビューする人は増えません。 エージェント(自律的に作業を進めるAI)が数百ファイルの差分を出してきたとき、誰が何を基準に正しいと判断し、誰がマージを承認するのか。ここが決まっていないと、AIが速く書いたぶんだけ、レビュー待ちの差分がたまっていきます。
この記事では、Anthropic が 2026年9月に公開した「How to prepare for AI-driven code modernization projects」をもとに、着手前に準備しておくべきことを6つのステップに分けて整理します。全体を通して、次の2つの問いを軸にしています。
- 今回の改修で、どの業務ルール・処理結果の変更を許すのか
- どんな検証結果が出たら、チームはマージしてよいと判断するのか
この2つが曖昧なまま始めると、エージェントが一通り作業を終えたあとで「思っていたのと違う」と言われ、やり直しになります。
ステップ1:改修の種類を決め、現状を把握する
3種類の改修で「正解」が変わる
「古いシステムを改修しよう」とチームで合意しても、思い描いているものは人によって違います。
- 運用担当は「技術スタックだけ新しくして、業務ロジックには触れないでほしい」
- 開発担当は「ついでに技術的負債も返したい」
- 業務部門は「作り直すなら、新しい要件も入れてほしい」
どれも筋は通っています。ただ、この状態で AI に作業させると、出てきたコードを評価する基準がありません。旧システムと同じ結果を返せば正解なのか、新しいルールに従っていれば正解なのか、決まっていないからです。
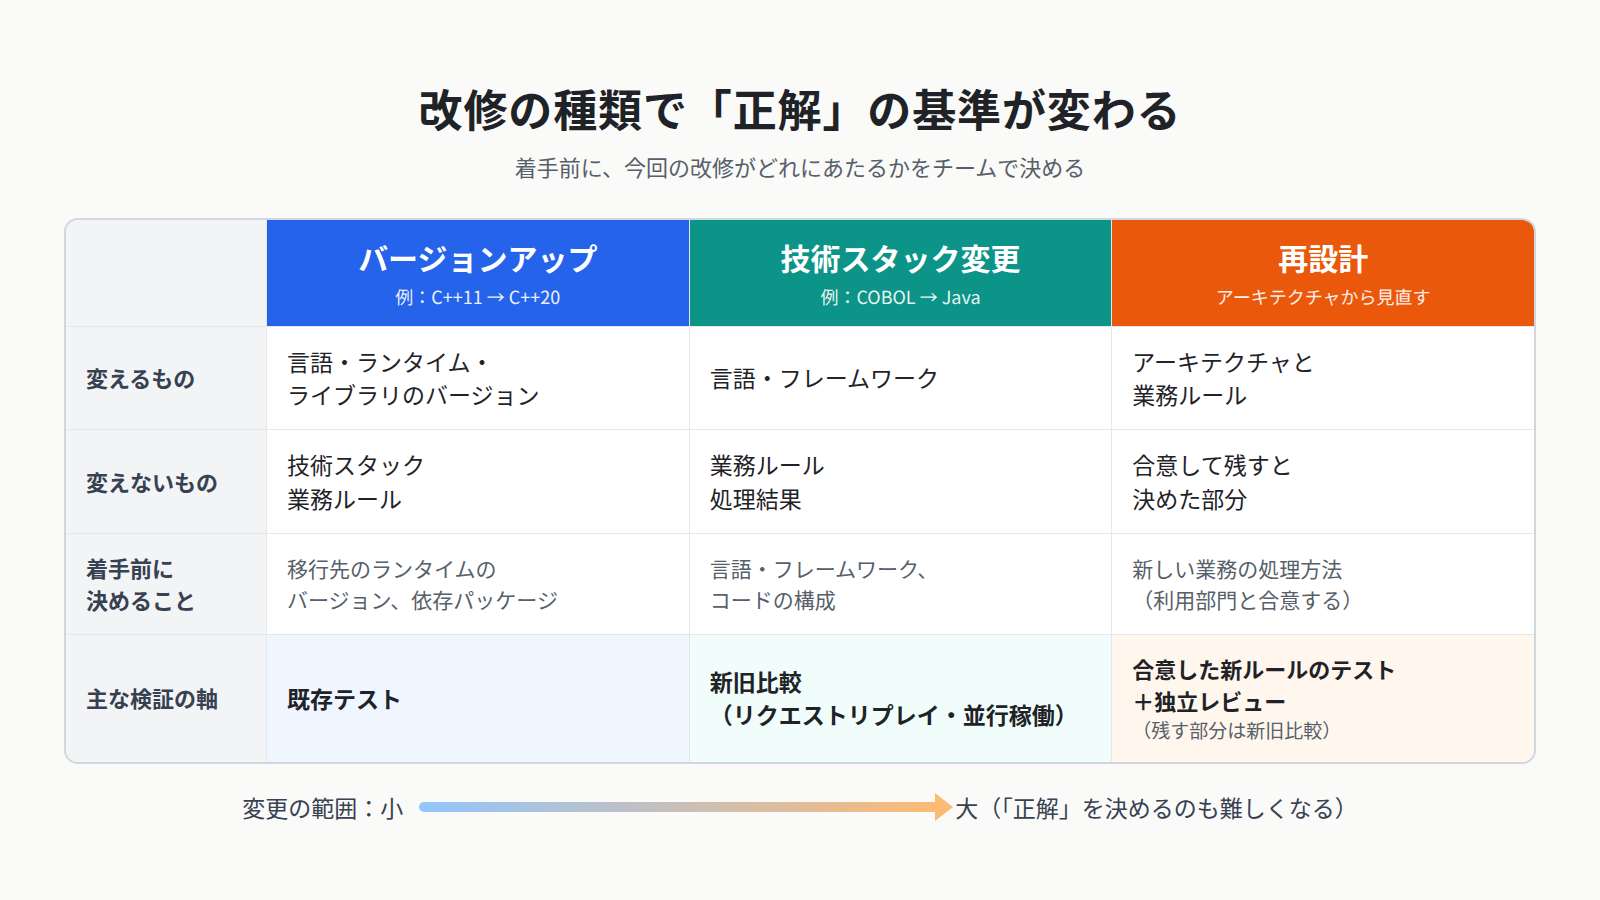
そこで最初に、今回の改修が次のどれにあたるかを決めます。
| 種類 | 何を変えるか | 何を変えないか | 決めておくこと |
|---|---|---|---|
| バージョンアップ | 言語・ランタイム・ライブラリのバージョン(例:C++11 → C++20) | 技術スタック、業務ルール | 移行先のランタイムのバージョン、依存パッケージ |
| 技術スタック変更 | 言語・フレームワーク(例:COBOL → Java) | 業務ルール、処理結果 | 使う言語・フレームワーク、コードの構成(アーキテクチャ) |
| 再設計 | アーキテクチャと業務ルール | 合意して残すと決めた部分 | 新システムが業務をどう処理するか(利用部門と合意する) |
下に行くほど変更の範囲が広がり、「正解」を決めるのも難しくなります。この違いは、ステップ2の検証方法にそのまま関わってきます。
Code Modernization プラグインで現状を見える化する
改修の種類を決めるには、今のシステムが何をしているかを知る必要があります。ただ、十年以上動いているシステムでは、ドキュメントが実態に追いついていないことがほとんどです。
Anthropic は、Claude Code 向けに Code Modernization というプラグインを提供しています。コードモダナイゼーション(古いシステムを現代的な技術に置き換えること)のためのワークフローで、古いコードの分析、改修方針の整理、アップグレードや書き換えの支援までを段階的に進めます。現状把握には、主に次の3つの機能が役立ちます。
| 機能 | 何がわかるか |
|---|---|
assess | 使っている言語、コードの複雑さ、たまっている技術的負債などを評価レポートにまとめる |
map | モジュール同士の呼び出し関係や、データがどこを通るかを図にする |
extract-rules | コードに埋まっている業務ルールを抜き出し、説明として整理する |
extract-rules の使い方を、架空の例で見てみます。旧コードに「一定時間内に支払われなかった注文は自動でキャンセルする」という処理があったとします。Claude は、このルールの発動条件と処理内容を抜き出し、該当するファイル名と行番号を添えて示すことができます。その説明を手がかりにコードへ戻って確認すれば、このルールを改修後も残すかどうかを判断できます。
ディレクトリ名やファイル名だけを手がかりに、システムの動きを推測しなくても済みます。
コードに書かれていないことは人に聞く
ただし、Claude がコードを読み終えても、それでシステムを理解したことにはなりません。
業務担当者が実際にどう使っているか、開発者がどんな過去の取り決めを覚えているか。こうした情報はコードには書かれていません。担当者へのヒアリングや社内ドキュメントで補う必要があります。不要に見える古い処理でも、どこかの部署がまだ使っているかもしれません。
extract-rules の結果も、そのまま正しいとは考えず、人が照合してから使います。そのうえで、どのルールを残し、どれを変え、どれを削るかを決めます。
「改修しないリスク」も関係者と共有する
「今も問題なく動いているのに、なぜ手を入れるのか」という声は必ず出ます。この疑問には、きちんと答えておく必要があります。
放置にもコストがあります。
- ランタイムのサポートが終わる
- 脆弱性が見つかっても修正できない
- システムを理解している人が減っていく
改修の大きな価値は、こうしたリスクを下げることです。予算やリリースのリスクを話し合うときは、「改修したら何が起きるか」だけでなく、「改修しなかったらどうなるか」も並べて比べます。
改修の理由と目標は、プロジェクトを始める段階で、経営層、システムの責任者、そのシステムに依存しているチームに説明しておきます。口では「賛成」と言っても、いざ人を出してほしいときに誰も出せないのでは、プロジェクトは進みません。目標への合意と、人や予算を出す約束をセットで取り付けておきます。
ステップ2:「正しく直った」を証明する受け入れ条件を決める
自動で判定できる条件にする
Claude が「すべてのタスクが完了しました」と言ってきても、それだけでマージするのは不安です。特に大量のファイルが変わったときは、何を確認したのかが知りたくなります。
そこで、先に受け入れ条件を決め、修正ごとに、条件を満たした証拠(テスト結果や検査レポート)を添えさせます。ポイントは、条件を自動で判定できる形にすることです。そうすれば、エージェントは修正と検証を自分で繰り返し、どうしても通らないものだけを人に回せます。
受け入れ条件の候補には、次のようなものがあります。
- 既存のテストと新しく追加したテストが通る
- カバレッジ(テストで実行されるコードの割合)が基準を満たす
- 性能が許容範囲に収まる
- コンパイル、型チェック、静的解析、セキュリティスキャンで新たな問題が出ない
- 新旧システムに同じ入力を与えたとき、出力が一致する
- 新旧のバージョンが、互いに保存したデータや送ったメッセージを正しく読める(例:新バージョンが保存したデータを旧バージョンでも読めるか、フィールドが欠けたり意味が変わったりしていないか)
- ステージング環境(本番に近い検証環境)で決められた期間動かし、エラー率・応答時間・アラートが悪化しない
- 画面のあるシステムなら、Claude に画面を操作させ、既存の機能が壊れていないかを確認する
注意したいのは、「基準を満たす」の中身を事前に数値で決めておくことです。カバレッジは何%以上か。性能はどこまでのブレなら許すのか。ここを決めずに結果を見ると、ある人は「この程度の差なら問題ない」と言い、別の人は「これでは出せない」と言い、話がまとまりません。
改修の種類ごとの検証方法
「既存テストが全部通れば十分では?」と考えるかもしれません。それで足りるかどうかは、改修の種類によって変わります。
バージョンアップの場合は、既存のテストが受け入れ条件の中心になります。
技術スタック変更では、言語やフレームワークが変わるので、旧テストがそのままでは動かないことがよくあります。そこで、新旧システムの処理結果を比べて検証します。方法は主に2つです。
- リクエストリプレイ:本番で記録したリクエストを新システムに流し直し、旧システムと同じ結果になるかを確かめる
- 並行稼働:旧システムでサービスを続けながら、新システムにも同じ入力を処理させ、両者の結果の差を見る
再設計で業務ルールも変える場合は、まず新しいシステムがどんなケースでどう処理すべきかを文書にし、利用部門と合意します。そのうえで、合意した内容をもとにテストを書きます。さらに、修正が要件に合っているかを Claude に独立したレビューで確認させます。旧ルールのまま残す部分は、引き続き新旧の比較で検証できます。
この3つの中で、再設計がいちばん難しいケースです。文章で書いた要件には解釈の幅があり、モデルの判断に頼る部分も増えるからです。要件の抜けが見つかったら、そのつど補い、受け入れ条件も合わせて見直します。
コードレビューは「別の会話」で行う
Claude にレビューさせるときは、コードを書いたときとは別の、新しい会話で行います。渡すのは、レビューに必要なコード、要件、資料だけにします。そのうえで、直さなければリリースできない問題を探させます。
コードを書いたのと同じ会話のままレビューさせると、Claude はそれまでの考え方の流れに沿って判断しがちです。書いたときに見落とした問題を、レビューでも同じように見落とすおそれがあります。
テストが乏しいプロジェクトでは、先に検証の土台を作る
古いプロジェクトでは、テストがほとんどないことも珍しくありません。通ったり落ちたりする不安定なテストがあったり、監視が不十分だったりもします。この状態では、受け入れの根拠として使えません。
その場合は、改修に入る前に、Claude にテストを補わせたり、リクエストリプレイのツールを作らせたり、新旧比較の環境を整えさせたりします。検証の土台を先に作ってから、本来の改修に進みます。
AIが自分で合否を判定できる完了条件の書き方は、Claude Code プランモード入門でも扱っています。
受け入れ条件は関係者と一緒に決める
受け入れ条件は、開発チームだけで決めないようにします。開発者、利用部門、業務の責任者に集まってもらい、検査項目の一覧を見せてこう聞きます。
「これが全部通ったら、マージしてよいですか?」
まだ不安だと言われたら、何の確認が足りないのかを聞いて、条件に加えます。AIが改修を終えてから「この結果では認められない」と言われるより、ずっと手戻りが少なくて済みます。
ステップ3:レビューをボトルネックにしない
影響範囲とリスクでレビューの深さを分ける
受け入れ条件を通った修正を、どうやって本番に出すか。誰が、どこまでレビューし、何を満たせばリリースできるのかも、事前に決めておきます。
すべての修正を人が一行ずつ読む運用にすると、エージェントが速く出すほどレビュー待ちが積み上がります。書く作業からは解放されたのに、夜までレビューに追われる。そんな状態になりかねません。
そこで、レビューの深さを段階に分けます。判断材料は次のとおりです。
- 修正がどの機能に影響するか
- テストの結果
- レビューで見つかった指摘
- エージェント自身が「確信が持てない」と示した箇所
社内にすでにリスク分類の基準があれば、それを使います。そのうえで、決済や会計など重要な業務フローに関わる修正は、これまでどおり人が全件レビューします。
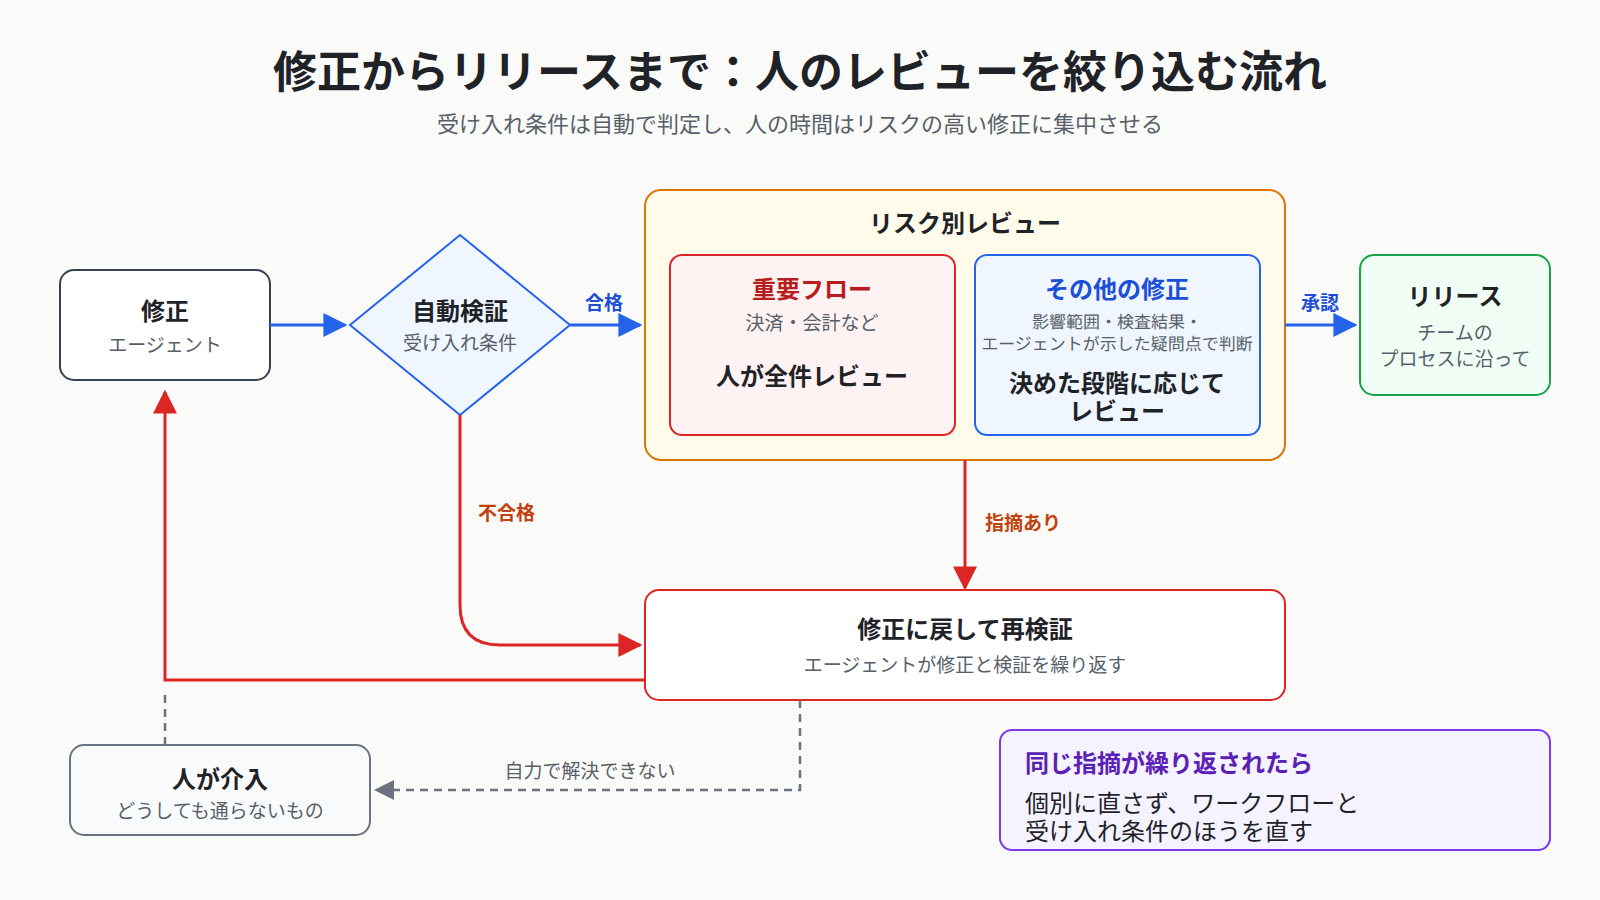
システムをいちばんよく知っている専門家には、最後の確認だけでなく、早い段階から入ってもらいます。修正のサンプルを見てもらい、どの検査結果が役に立つか、レポートをどう並べると確認しやすいかを先に決めておきます。そうすれば、本番のレビューで、リスクの高い修正やエージェントが示した疑問点にすぐたどり着けます。
専門家がサンプルと検査結果を確認して納得すれば、確度の高い修正については人のレビューを減らす根拠ができます。ただし、どこまで減らすかは事前に決めたルールに従い、重要フローの全件レビューは残します。同じ種類の指摘が繰り返し出る場合の対処は、ステップ5で扱います。
責任の所在とスピードのトレードオフ
レビューをどこまで細かくするかは、スケジュールにも左右されます。ランタイムのサポート終了が目前に迫っている場合と、時間をかけて移行できる場合とでは、取れる選択が違います。リリースを急ぐなら、そのぶん受け入れる追加のリスクを事前に明らかにしておきます。
ここで必ず出るのが、「レビューを減らして早く承認して、問題が起きたら誰が責任を取るのか」という問いです。「AIを信じましょう」では答えになりません。
Anthropic は、規制のある業界の企業では、レビューの深さとリスクの取り方を経営層が主導して決め、既存の変更管理プロセスに沿って運用することを勧めています。スピードを求めた結果、承認ボタンを押した人だけが責任を負う形にしてはいけません。そのためには、受け入れの証拠が十分であること、そして、Claude がなぜそう修正し、何を確認したのかをレビュー担当者が理解できることが前提になります。
ステップ4:着手前に環境と権限を整える
ここまで決まったら、すぐにエージェントを動かしたくなります。ただ、その前に確認することがあります。エージェントを動かす環境はあるか。テストデータは使えるか。レビュー担当者の時間は取れているか。
こうした準備の多くは、ほかのチームとの調整が必要です。エージェントはいつでも動けますが、人の予定はそうはいきません。ステップ1〜3を進めている段階から、並行して準備を始めておくのが現実的です。
環境
- エージェント専用のリモートホストを用意し、コードと関連資料にアクセスできるようにする
- 受け入れ条件に合わせて、テスト用のリソース、本番の監視データ、リプレイ用のリクエスト記録、新旧並行稼働の環境を用意する
コードと CI/CD
- 依存関係を整理する。プラグインが出す依存図を出発点にし、ビルドログ、コード内の import、実行時の呼び出し記録と照らし合わせる
- 置き換える依存や、互換性チェックの要否を決める
- 既存のコードベース上で直接アップグレードする場合は、どの部分の通常の変更をどれくらいの期間止めるか(コードフリーズ)を決める。あわせて、アップグレード後の互換性の要件を開発中のメンバーに伝える
関係チーム
- そのシステムに依存しているほかのチームが、受け入れ条件の確認に加わるのか、レビューにも参加するのかを決める
- 誰に、いつ時間をもらうかを先に押さえる。コードができあがってから、判断できる人の予定が空いていないと気づくのでは遅い
権限とセキュリティ
- 今使っている Claude Code の利用形態でソースコードを扱ってよいか、社内のルールを先に確認する
- エージェントが書き込めるのは改修用のブランチだけにする
- 本番環境のアカウント、パスワード、アクセスキーは渡さない
- 改修ブランチに含まれる機密情報や個人情報は、削除するかマスキング(伏せ字化)する
- 各 PR にエージェントの実行ログと受け入れ結果を添え、コードがどう作られたかを後から追えるようにする
- 新しい依存を入れるときは、ライセンス要件と既知の脆弱性を確認する
AIコーディングでの権限の切り分けは、AIコーディングのセキュリティ設計でも詳しく扱っています。
ステップ5:要件を渡し、小さく試してワークフローを直す
要件をエージェントが読める場所に置く
準備が整ったら、Claude Code にタスクの割り振り、コードの修正、結果の確認、失敗時の対応までを一つの流れとしてつなげさせます。Code Modernization プラグインのワークフローを出発点にしてプロジェクトに合わせて調整し、作業は複数のサブエージェント(親のエージェントから仕事を分けてもらうエージェント)に分担させます。
ここで忘れがちなのが、会議で決めたことを Claude は知らないという点です。目標、受け入れ条件、レビューのルール、ソースコード、ドキュメント、検証に使うデータやツールは、すべて Claude がアクセスできる場所に置く必要があります。
渡し方は、Claude が読めるディレクトリに置くか、MCP(Claude Code を外部のツールやデータにつなぐ仕組み)で接続するかです。MCP の基本は Claude Code MCP完全入門 を参考にしてください。
小さく試して、失敗をワークフローに反映する
いきなりリポジトリ全体に適用するのは避けます。まず狭い範囲で試し、業務の専門家に、修正されたコード、エージェントの作業の過程、提出された受け入れの証拠を確認してもらいます。
extract-rules で抜き出した業務ルールや、このプロジェクト専用に用意した Skills(Claude に渡す手順書や知識をまとめておく仕組み)も、専門家が確認してから後続のエージェントに渡します。
試しに10か所を直させたところ、5か所で同じ種類の間違いが出たとします。その5か所を手で直して終わりにしてよいでしょうか。後ろにはまだ何百か所も残っています。
直すべきなのは、個別の修正ではなく、エージェントの手順や検査ルールのほうです。 次の対象で同じ間違いが起きないようにします。これは本番の運用に入ってからも同じで、同じ指摘が繰り返し出るなら、専門家が毎日同じ間違いを直し続ける前に、ワークフローや受け入れ条件を見直します。
小さな範囲で試す目的は、範囲を広げたときの結果にチームが自信を持ち、決めたルールどおりにレビューとマージを進められる状態にすることです。
ステップ6:通しで一度試してから、全体に広げる
修正からリリースまでを一度通す
小さな範囲での試行がうまくいっても、まだリポジトリ全体には進みません。その前に、通しの演習を一度行います。
ステップ5までは「どう直すか」が中心でした。通しの演習では、一部のコードについて、修正 → 受け入れ → レビュー → マージ → リリースまでを実際の流れどおりに進めます。正しいコードが書けることと、そのコードがチームのプロセスに沿ってリリースできることの間には、まだいくつも関門があります。引っかかる箇所があれば、範囲が小さいうちに直し、確信が持ててから広げます。
依存の末端から順に広げる
進め方は改修の種類で変わります。
- 技術スタック変更・再設計:旧システムの横に新システムを作り、完成したら切り替えるのが一般的
- バージョンアップ:通常の開発を続けているコードベースの中で、分割して進めることもできる
「コードを複製して、別の場所で静かにアップグレードすればいいのでは」と思うかもしれません。ただ、その間も元のプロジェクトには毎日新しいコードが入ってきます。2つのコードを同期し続ける手間が大きい場合や、システムを止められない場合は、既存のプロジェクトの中で分割して進める方法を検討します。
分割して進めるときは、モジュールの依存関係に沿って順番を決めます。たとえば A が B を呼び、B が C を呼んでいるなら、末端の C から始めて、B、A の順に進めます。止めるのは一度に一つのモジュールの通常の変更だけにし、アップグレードと確認が終わったら次へ進みます。モジュール同士が互いに依存している(循環依存がある)場合は、この順番をそのまま当てはめられません。どの部分を一緒に扱うかを先に整理します。
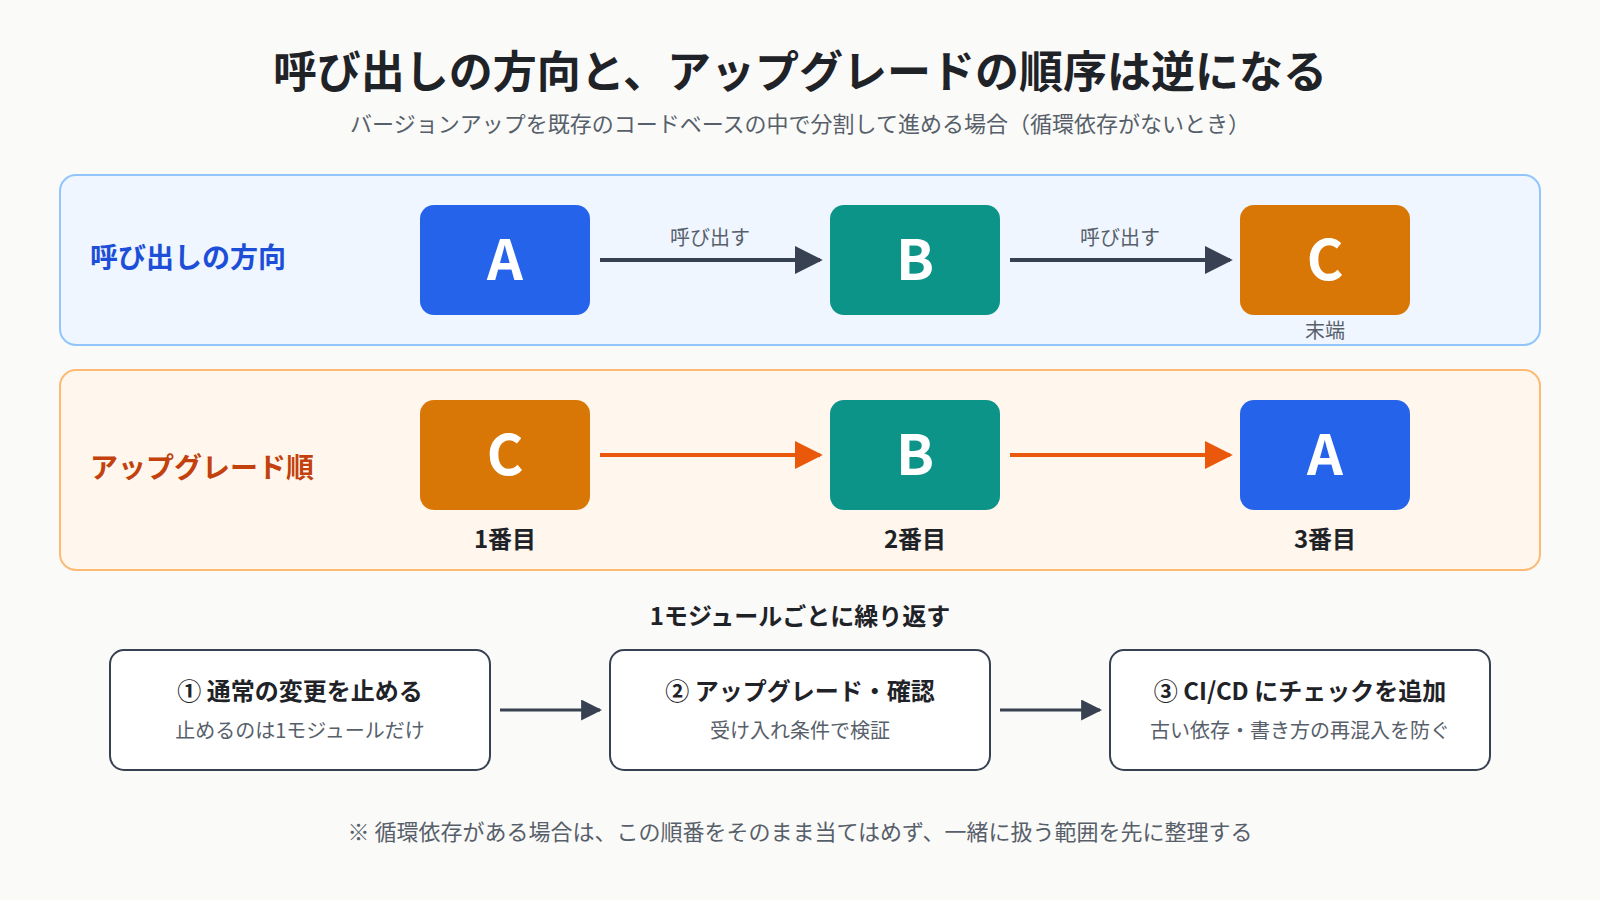
あるモジュールのアップグレードが終わったら、CI/CD にチェックを追加します。あとから入るコミットで、古いバージョンの依存や互換性のない書き方が戻ってこないようにするためです。開発中のメンバーにとっても、どこがすでに新しい要件に移ったのかがわかるようになります。
コストの見積もりとモデルの使い分け
行数では見積もれない
最後に費用です。AI による改修のコストは、コードの行数だけでは見積もれません。トークン(AIが処理するテキストの単位で、利用料金の基準になる)の消費量は、次のような要素で大きく変わります。
- Claude が読む量と書き換える量
- 検証の複雑さ
- 新しく書くテストの量と、直す必要がある既存テストの量
- 改修中もほかのチームがコードをマージし続けることによる、同期の手間
特に規制のある環境では、修正を書くよりも、修正が正しいと示す検証のほうがトークンを多く使うことがあります。「コードを書く費用」だけを見ていると、見積もりを大きく外します。
現実的なのは、小さな範囲で試したときの使用量を記録し、そこから全体を推算する方法です。ただし、継続的な開発に伴う同期作業など、試行の範囲に入っていなかった作業はまだ見積もれません。あとで追加予算が必要になる可能性があるので、この推算は最終的な見積もりではなく、下限の目安として扱います。
費用を抑えるには
まず、試行時の使用量の記録を見て、どの工程でトークンを多く使っているかを確かめます。そのうえで、次のように調整します。
- 安い検査を先に回す:軽い検査に通ったものだけを、重い検証に回す。明らかに不合格の修正に、コストの高い検証まで実行させない
- 作業に合わせてモデルを使い分ける:繰り返しが多く量もあり、自動検査で合否を判定できる作業には、Sonnet のようにコストと能力のバランスがよいモデルを使う。複雑なロジックの書き換えや、問題や見落としを積極的に探すレビューには、より能力の高いモデルを使う
- 安いモデルから始めて、通らなければ上位モデルに切り替える
ただし、単価だけで判断しないでください。安いモデルが何度もやり直すと、上位モデルが一度で終えるより高くつくこともあります。試行では、使用量に加えてやり直しの回数も記録しておきます。その記録とワークフローを Claude に渡せば、見直す箇所を一緒に洗い出せます。
まとめ:AIに頼む前に、チームで答えておく2つの問い
AIでレガシーコードを改修するとき、難しいのはコードを書くことではありません。その修正が正しいと示し、チームが納得してリリースできる状態を作ることです。
この記事で整理した準備は、次の6つでした。
- 改修の種類を決め、現状を把握する(Code Modernization プラグイン+人へのヒアリング)
- 自動で判定できる受け入れ条件を、関係者と一緒に決める
- リスクに応じてレビューの深さを分け、責任の所在をはっきりさせる
- 環境・依存関係・関係チーム・権限を、早めに並行して準備する
- 要件をエージェントが読める場所に置き、小さく試してワークフローを直す
- 通しで一度試してから、依存の末端から順に広げる
Claude Code に「全部アップグレードして」と頼む前に、チームで次の2つに答えておいてください。
- 今回、どの業務ルールと処理結果の変更を許すのか
- どんな検証結果が出たら、マージしてよいと判断するのか
改修が終わったとき、チームの手元に残るのはアップグレードされたコードだけではありません。実際に回したワークフロー、関係者が合意した受け入れ条件、レビューとリリースのルール、修正ごとの証跡も残ります。これらを整理しておけば、次の改修でそのまま使えます。
AIで実装が速くなったあと、開発プロセスのどこが詰まりやすくなるかは、AIネイティブSDLC入門で詳しく扱っています。
自社システムへの AI 導入、まずは無料でご相談ください
現状を伺ったうえで、進め方をご提案します。初回30分は無料です。
関連記事
企業の AI 活用 5 段階|自社はいまどこにいるのか
「AI を入れたい」と考えたら、まず自社がいまどの段階にいるかを確かめることです。業務のデジタル化から AI が自ら動く段階まで、企業の AI 活用を 5 つの段階に分け、日本の現場の実態に合わせて解説します。各段階の「進んだと言える条件」と「よくある落とし穴」も整理しました。
企業 AI 導入の全体像|1 枚の図で見る 12 の要素
「AI を業務に入れたい」と言われても、何から手を付ければいいのか分からない。そんな方のために、企業の AI 導入を 12 の要素に分けて 1 枚の図にまとめました。困りごとの整理から、知識の資産化、既存システムとの連携、段階的な展開、リスク対策まで、日本の現場の言葉で解説します。
AIコーディングのセキュリティ設計|AIが8割書く時代の境界線
AIがコードの大半を書くようになると、従来のレビュー体制は速度に追いつけません。Anthropicの実例をもとに、プロンプトインジェクションなど新しい3つの攻撃面と、シフトレフト・権限分離・決定論的チェックという防御の柱を整理し、小さなチームが今日から引ける境界線の作り方を解説します。