Claude Code のサブエージェント並列実行入門|4つの仕組み・3つの上限・始め方
Claude Code でサブエージェントを並列に動かす4つの仕組みと、同時実行数・総数・ネストの深さという3つの上限を解説します。「568体同時実行」の真偽、worktree によるファイル衝突の対策、コストを抑えて小さく始める方法まで整理しました。
要点
- サブエージェントの一番の価値は並列ではなくコンテキスト分離で、親には結果の要約だけが返る
- 並列の仕組みはセッション内サブエージェント、agent view、agent teams、dynamic workflows の4つ
- コンテキストが分離されていてもファイルの衝突は防げないため、worktree か担当ファイルの分割で対策する
- 上限は同時実行数・1回の総数・ネストの深さの3軸で考える。既定値は環境変数で変えられる
- 体数を増やすとトークンと結果をまとめる手間が先に限界になるため、小さく始めてレビューできる量だけ増やす
目次
「AI の社員を何百人も同時に動かし、一人で“部署”を回す」。そんな動画が話題になりましたが、Claude Code の並列実行はもっと具体的な仕組みの上に成り立っていて、はっきりした上限もあります。
この記事では、サブエージェントの基本から、並列実行の4つの仕組み、上限とコスト、安全な始め方までを順に整理します。数値やバージョンは2026年11月時点(Claude Code v2.1.316)の公式ドキュメントと変更履歴に基づきます。既定値は更新で変わることがあるため、実際に使う前に公式ドキュメントで確認してください。
この記事でわかること
- サブエージェントとは何か、なぜ「コンテキスト分離」が重要なのか
- 並列実行を支える4つの仕組みの違い
- 複数のエージェントが同じファイルを書き換えないための対策
- 「何体まで動くか」を考えるための3つの軸
- 体数を増やしすぎると何が起きるか
- 最初に試すべき規模と入口
サブエージェントの基本:作業を任され、要約だけを返す
オーケストレーターとサブエージェント
Claude Code で複数のエージェントを使うとき、全体を指揮するのはメインの Claude です。これをオーケストレーターと呼びます。オーケストレーターは仕事を切り分けてサブエージェントに任せ、返ってきた結果をまとめます。
サブエージェントはそれぞれ、専用のシステムプロンプト、使えるツール、権限の設定を持てます。
価値の中心は「コンテキスト分離」
サブエージェントの一番の価値は、並列で動くことよりも、作業の途中経過を親に持ち込まないことにあります。
各サブエージェントは、自分専用のコンテキストウィンドウで動きます。コンテキストウィンドウとは、AI がその場で覚えておける作業メモの容量のようなものです。たとえば調査担当のサブエージェントが50個のファイルを読んでも、その内容はサブエージェントの中に閉じたままです。親に返るのは結果の要約だけなので、オーケストレーターの会話は軽いまま保たれます。
Claude Code には、この考え方で作られた組み込みのサブエージェント Explore と Plan があります。どちらも読み取り専用で、検索や計画づくりをメインのコンテキストの外で済ませるためのものです。
役割(ロール)は Markdown ファイルで定義する
自分でサブエージェントの役割を作ることもできます。ロールは YAML frontmatter 付きの Markdown ファイルで、必須項目は name と description の2つだけです。必要に応じて次のような項目を追加します。
| 項目 | 役割(概要) |
|---|---|
tools / disallowedTools | 使えるツール・使えないツール |
model | そのロールで使うモデル |
permissionMode | 権限の扱い |
isolation | 作業環境の分離(後述の worktree) |
maxTurns | 最大ターン数 |
hooks / mcpServers | フックや MCP サーバーの設定 |
ファイルの置き場所は5種類あり、同じ名前のロールがあるときは次の順で優先されます。
- 組織の管理設定
- CLI の
--agentsオプション(そのセッションだけ) - プロジェクト(
.claude/agents/) - ユーザー(
~/.claude/agents/) - プラグイン
プロジェクト単位で置けば、チームの「部署構成」をリポジトリでバージョン管理できます。
並列実行を支える4つの仕組み
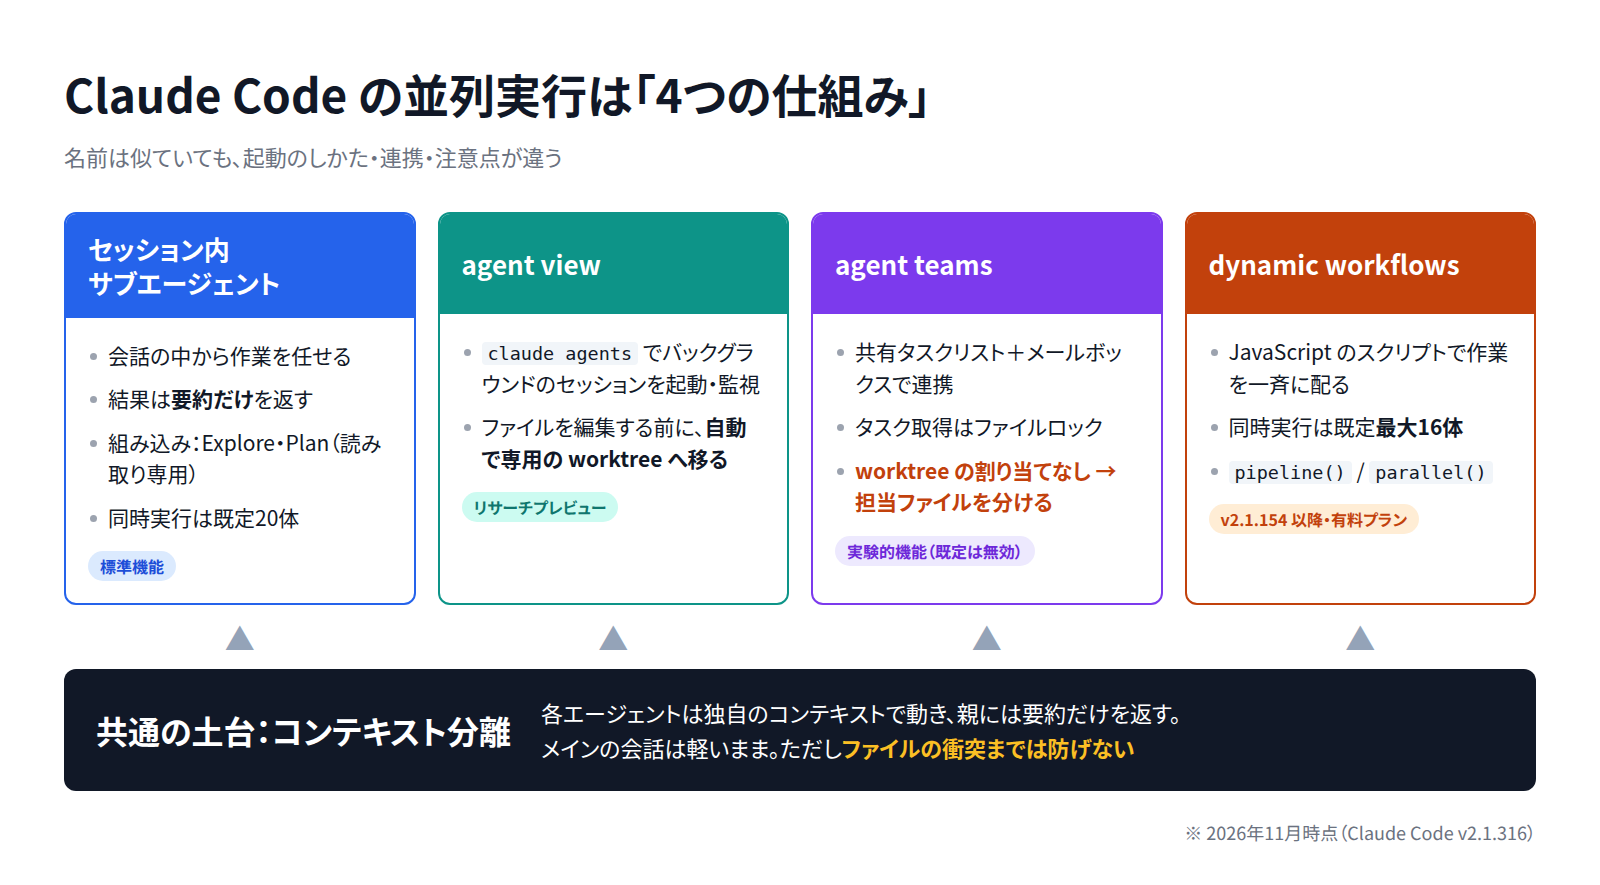
「サブエージェントを並列で動かす」と言っても、Claude Code には性格の違う仕組みが4つあります。名前が似ているので、まず違いを押さえておきましょう。
| 仕組み | どんなものか | 状態 |
|---|---|---|
| セッション内サブエージェント | 会話の中から作業を任せる標準の方法。分離されたコンテキストで動き、要約だけを返す | 標準機能 |
| agent view | claude agents で開く画面から、バックグラウンドのセッションを起動・監視する | リサーチプレビュー |
| agent teams | リーダー役のセッションが、共有のタスクリストとメールボックス(メッセージのやり取り)で複数のセッションを取りまとめる。CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS=1 で有効化 | 実験的機能(既定は無効) |
| dynamic workflows | Claude が書いた JavaScript のスクリプトを、ランタイムがバックグラウンドで実行し、多数のサブエージェントに作業を配る | 有料プランで利用可(Pro は /config で有効化) |
これらは一度に揃ったわけではなく、バージョンを重ねて段階的に加わりました。
- v2.1.32:agent teams(リサーチプレビューとして追加)
- v2.1.139:agent view
- v2.1.154:dynamic workflows
- v2.1.198:サブエージェントが既定でバックグラウンド実行に
- v2.1.217〜v2.1.219:同時実行数の上限を追加、ネストの既定値を変更(後述)
どの仕組みも、土台にあるのは先ほどのコンテキスト分離です。
コンテキスト分離だけではファイルの衝突は防げない
注意したいのは、コンテキストが分離されていても、複数のエージェントが同じファイルを書き換える衝突までは防げないという点です。考えていることが混ざらないことと、作業の調整がとれていることは別の話です。
git worktree で作業場所を分ける
ファイル単位の安全性を確保するのが git worktree です。worktree は、1つのリポジトリから作業用のチェックアウトを複数作れる git の機能で、エージェントごとに別の作業フォルダとブランチを持たせられます。
Claude Code では、次の方法で worktree を使えます。
- サブエージェント:ロール定義に
isolation: worktreeを書く。サブエージェントごとに一時的な worktree が作られ、変更がなければ終了時に自動で削除される - 自分で起動するセッション:
claude --worktree <name>で起動する。.claude/worktrees/<name>/に、worktree-<name>というブランチのチェックアウトが作られる
仕組みによっては worktree が自動で使われます。
- agent view:起動したセッションは、ファイルを編集する前に専用の worktree へ移る
/batch:1つの大きな変更を、worktree で分離した5〜30個のサブエージェントに分割して進める
agent teams はファイルの担当分けが必要
agent teams には、同じタスクを複数のメンバーが同時に取らないようにする「ファイルロック付きのタスク取得」があります。ただし、メンバーごとに worktree を割り当てる機能はありません。
そのため、メンバーにコードを編集させる場合は、どのファイルを誰が担当するかをあらかじめ分けておく必要があります。公式ドキュメントも、同じファイルを2人が編集すると上書きが起きるため、メンバーごとに担当ファイルを分けるよう勧めています。
何体まで動かせるのか:上限は3つの軸で考える
「何体まで動かせるか」は、次の3つの軸に分けて考えると混乱しません。
| 軸 | 既定の上限 | 変更方法 |
|---|---|---|
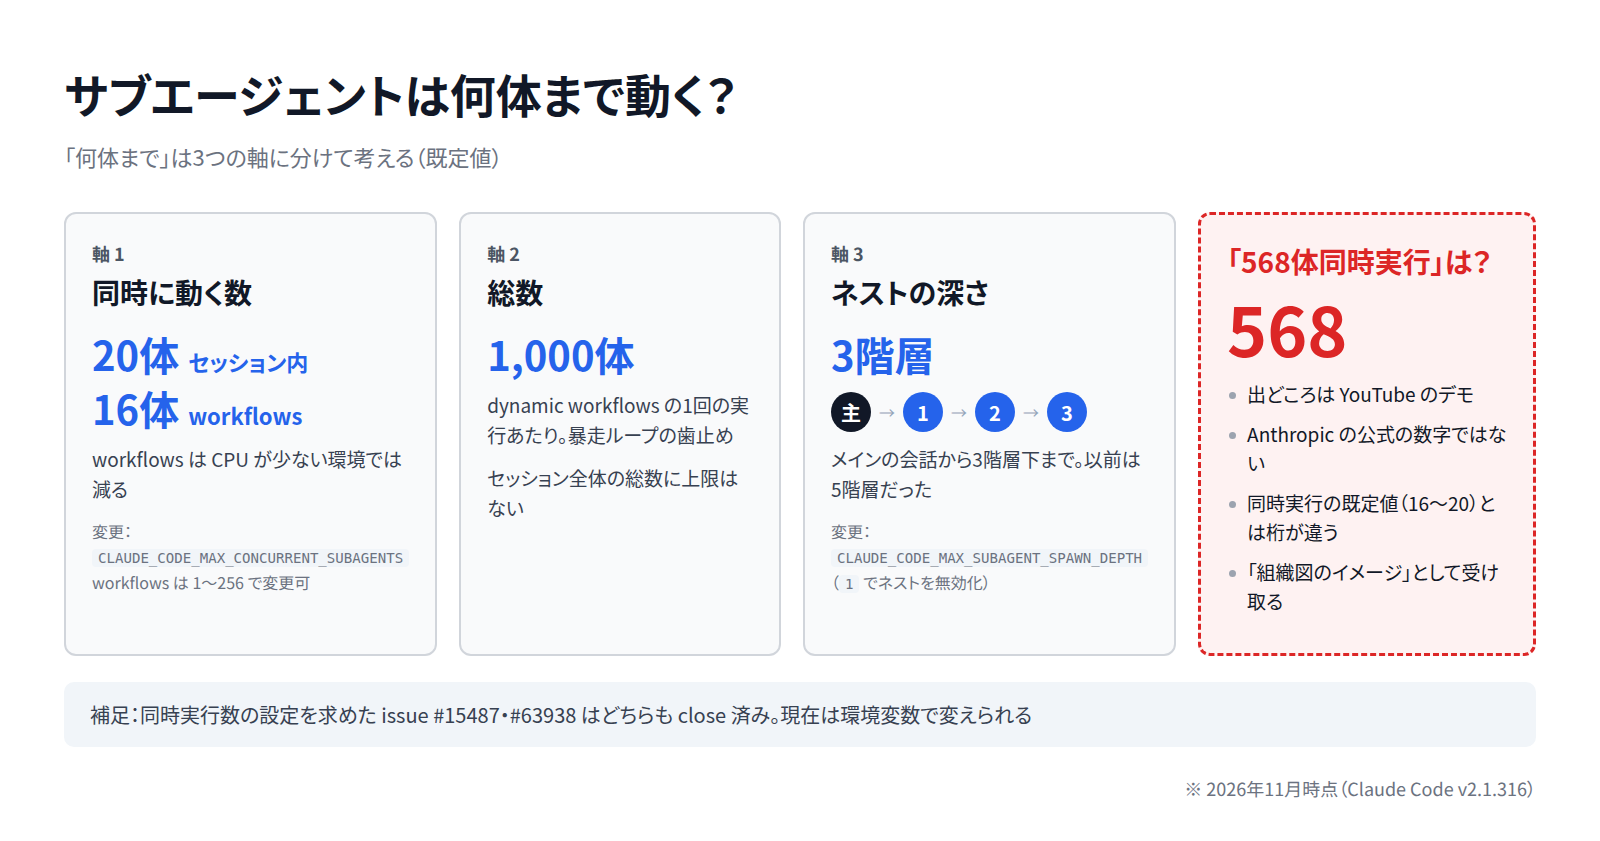
| 同時に動く数 | セッション内のサブエージェントは20体。dynamic workflows は1回の実行につき最大16体(CPU が少ない環境では減る) | CLAUDE_CODE_MAX_CONCURRENT_SUBAGENTS、workflows は CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS(1〜256) |
| 総数 | dynamic workflows は1回の実行で1,000体まで(暴走ループの歯止め)。セッション全体の総数に上限はない | なし |
| ネストの深さ | メインの会話から3階層下まで | CLAUDE_CODE_MAX_SUBAGENT_SPAWN_DEPTH(1 でネストを無効化) |
ネストの上限は、何度か変わっています。以前は5階層でしたが、v2.1.217 でいったんネストが既定で無効になり、v2.1.219 から既定で3階層になりました。
同時実行数の設定も、以前はありませんでした。同時実行数を指定できるようにしてほしいという GitHub の issue(#15487、#63938)はどちらも close され、現在は上の表の環境変数で変えられます。
「568体同時実行」は公式の数字ではない
話題になった「568体のサブエージェントを同時に動かす」という数字は、YouTube のデモ動画が出どころで、Anthropic の公式情報ではありません。
上の表のとおり、同時に動く数の既定値は16〜20体です。公式ドキュメントが示している dynamic workflows の規模も「1回の実行で数十〜数百のエージェント」です。568体が一度に動く使い方は文書化されておらず、組織図のような「イメージ」として受け取るのが妥当です。
増やすほど得ではない:コストとまとめる手間
トークンの消費は体数にほぼ比例する
エージェントを増やせば、そのぶんコストも増えます。
- サブエージェントは、それぞれ親とは別にリクエストを送るため、その分も利用枠から消費される
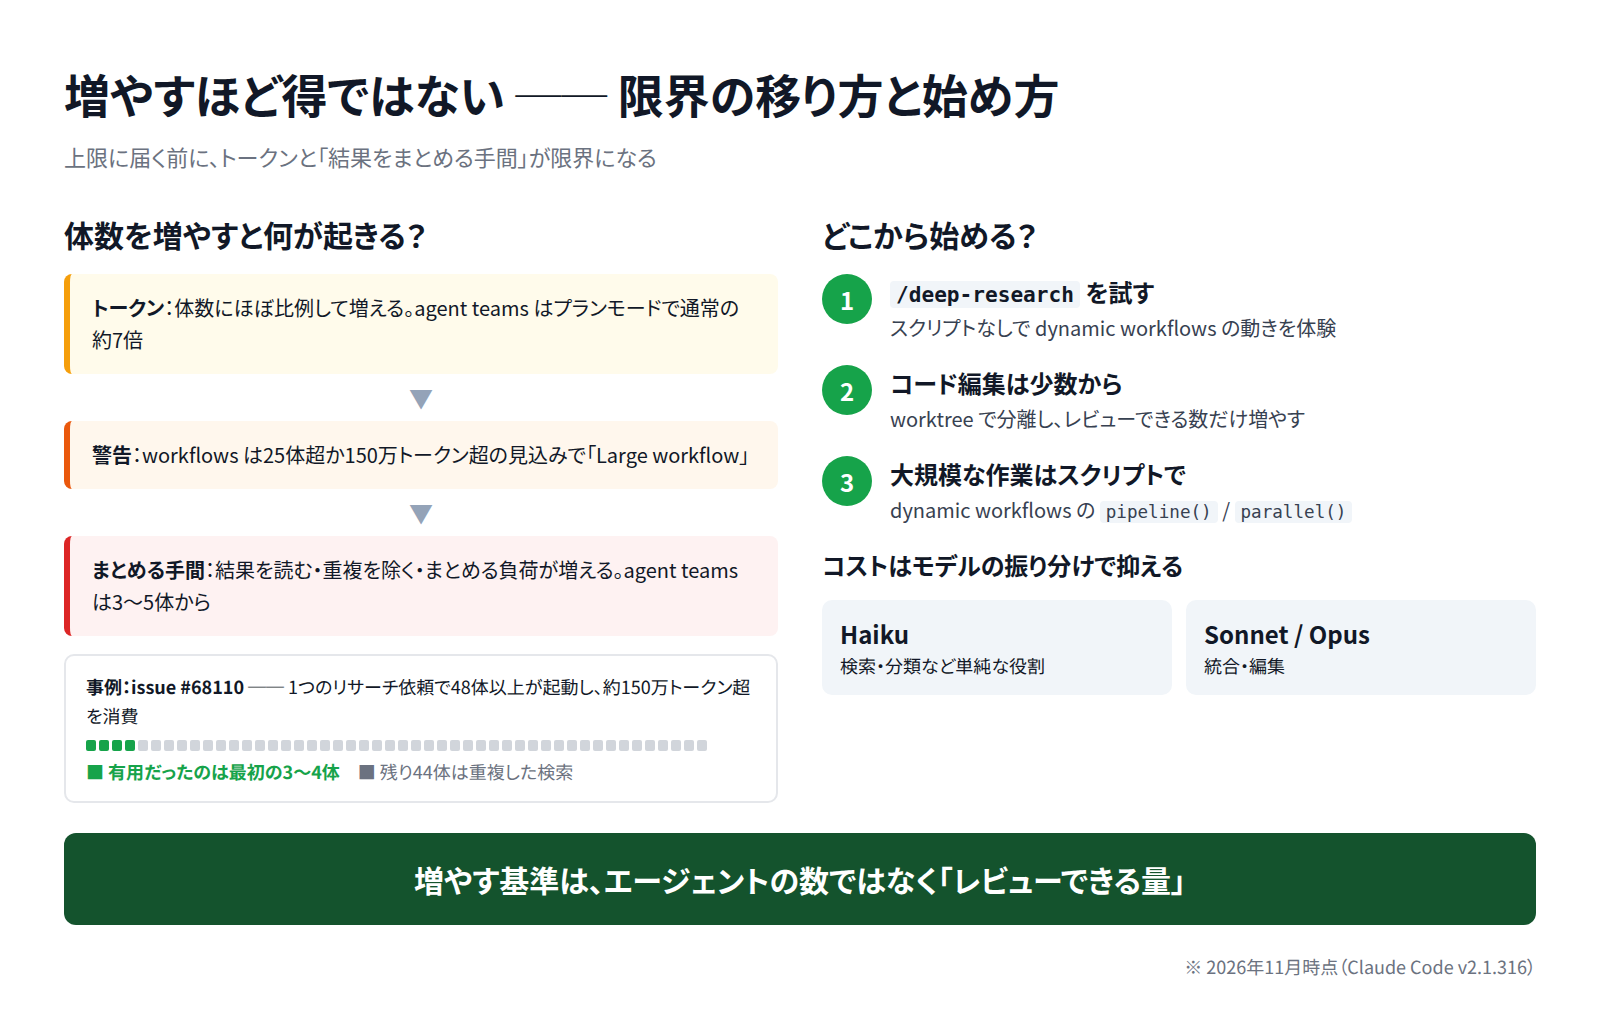
- agent teams は、メンバーごとに独立したコンテキストを持つため、トークン消費はメンバー数にほぼ比例する。公式ドキュメントでは、メンバーをプランモードで動かした場合、通常のセッションの約7倍のトークンを使うとしている
- dynamic workflows は、25体を超える計画か、見込みのトークン数が150万を超えると「Large workflow」という警告を出す
48体が起動してしまった事例
増やしすぎの典型例が、GitHub の issue #68110(2026年6月13日、Opus 4.6)です。1つのリサーチ依頼で、サブエージェントがさらに子のエージェントを起動し、48体以上がバックグラウンドで動いて約150万トークン以上を消費しました。有用な調査は最初の3〜4体で終わっていて、残りの44体は重複した検索をしていただけでした。
その後のバージョンで、同時実行数とネストの深さに既定の上限が入り、こうした際限のない増え方は起きにくくなっています。
結果をまとめる手間が先に限界になる
上限の内側でも、体数を増やせば増やすほど、エージェントが出した結果を読み、重複を除き、まとめる手間が増えます。この作業はオーケストレーターか人間が担うため、体数を増やしても速さは比例して上がりません。
公式ドキュメントも agent teams について、多くの作業は3〜5体から始め、同時に動かす意味があるときだけ増やすよう勧めています。焦点の定まった3体のほうが、散らばった5体より成果が出やすいとも書かれています。
「同時に大量」と「時間をかけて大量」は別物
大量の作業を任せること自体が悪いわけではありません。/loop やクラウドの定期実行(ルーティン)を使えば、作業を時間をかけて順番に進められます。大量の作業は、同時に詰め込むより時間方向に分散させるほうが、レート制限にも当たりにくく、結果も確認しやすくなります。
どこから始めるか:規模の目安と使い分け
基本方針は「小さく始めて、レビューできる範囲でだけ増やす」です。
- まず
/deep-researchを試す:dynamic workflows に同梱されているコマンドで、調査を複数のサブエージェントに分配し、主張をクロスチェックして、出典付きのレポートを返します。スクリプトを書かずに dynamic workflows の動きを体験できます。 - コード編集は少数から:worktree で分離したサブエージェントを、まずは数体で動かします。増やすかどうかは、計算資源ではなく、マージ結果を人がレビューできるかで決めます。
- 大規模な作業はスクリプトで:500ファイルの移行やコードベース全体の監査などは、dynamic workflows に任せます。項目ごとに独立して進められる処理は
pipeline()、複数の作業を同時に走らせてすべての結果が揃うのを待つ処理はparallel()で書かれます。
体数を大きく増やすのは、読み取り専用の作業、互いに依存しない作業、ファイルの担当がはっきり分かれた作業に限りましょう。dynamic workflows には、Claude が目指す体数の目安(5体未満〜50体未満)を /config で選べる設定もあります。
コストを抑えるには、ロール定義の model でモデルを振り分けます。検索や分類などの単純な役割には Haiku を、統合や編集には Sonnet や Opus を割り当てるのが基本です。
よくある質問
dynamic workflows を使うには、何が必要ですか?
v2.1.154 以降の Claude Code と、有料プランか API の利用環境が必要です。Pro プランでは /config の Dynamic workflows で有効にします。バージョンは claude --version で確認できます。
2つのサブエージェントが同じファイルを上書きしないようにするには?
worktree を使います。ロール定義に isolation: worktree を書くと、サブエージェントごとに別のチェックアウトが用意されます。agent teams はメンバーに worktree を割り当てないので、ファイルの担当を分けてください。
サブエージェントは何階層までネストできますか?
既定では、メインの会話から3階層下までです。環境変数 CLAUDE_CODE_MAX_SUBAGENT_SPAWN_DEPTH で変えられ、1 にするとサブエージェントがさらにサブエージェントを起動できなくなります。
まとめ
- サブエージェントの本質はコンテキスト分離。親には要約だけが返るので、メインの会話が軽く保たれる
- 並列実行は、セッション内サブエージェント、agent view、agent teams、dynamic workflows の4つの仕組みに分かれる
- コンテキストが分離されていても、ファイルの衝突は防げない。worktree かファイルの担当分けで対策する
- 上限は「同時実行数(既定16〜20)」「総数(workflows は1回1,000)」「ネスト(既定3階層)」の3軸で考える。「568体同時」は公式の数字ではない
- 体数を増やすと、トークンと結果をまとめる手間が先に限界になる。大量の作業は時間方向に分散させる
- まずは
/deep-researchを試し、コード編集は少数から始める。増やす基準はエージェントの数ではなく、レビューできる量
参考
自社システムへの AI 導入、まずは無料でご相談ください
現状を伺ったうえで、進め方をご提案します。初回30分は無料です。
関連記事
Claude Code Superpowers入門|AIに手順を飛ばさせない14のスキル
Claude Codeが「動くけれど頼んでいないことまでやる」原因は、賢さではなく手順を飛ばすことにあります。Superpowersが14個のスキルで設計・計画・実装・デバッグをどう縛るのか、v6.3.0時点の実挙動に沿って、スキルの選び方と使い分けまで解説します。
Claude Code コマンド整理術|「重い」の正体はコンテキスト
Claude Code の応答が重くなる原因は、モデルの性能ではなくコンテキストの使い切りにあります。有限のコンテキストウィンドウを起点に、/context・/compact・/clear など主要コマンドを「減らす・見る・戻す」の3つの役割で整理し、症状別の使い分けを解説します。
Claude Code プランモード入門|「動くけど違う」を減らす3ステップ
Claude Code が「動くけど求めたものと違う」コードを返すのは、範囲と完了条件が渡っていないからです。プランモードで探索・計画・実装を分ける手順と、AI自身が合否を判定できる検証の書き方、テストがない場合の代替まで解説します。